prompt caching
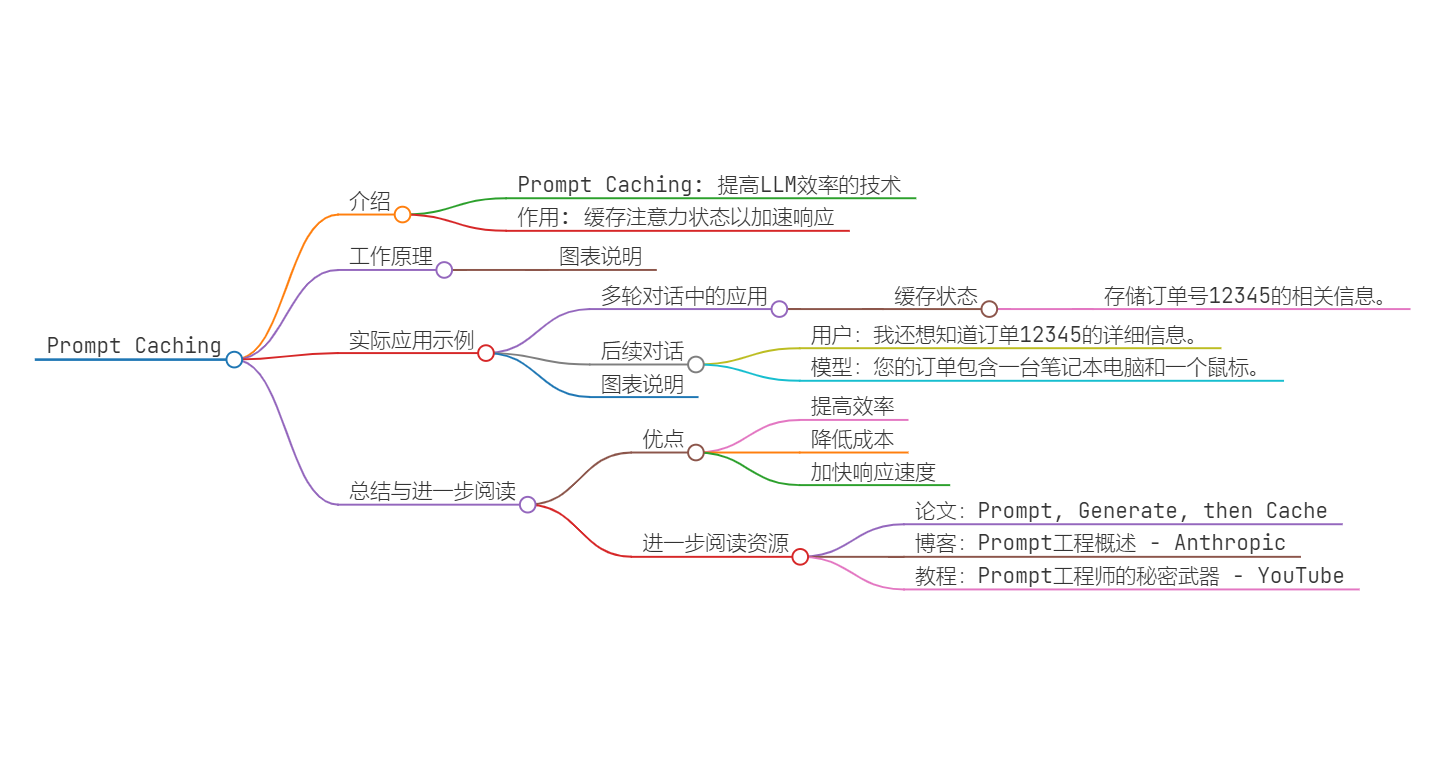
1. prompt caching 的概念
Prompt caching 是一种在大型语言模型(LLM)中使用的技术,旨在通过缓存和复用先前计算的注意力状态来提高模型的效率和响应速度。
其核心思想是将模型在处理某些输入时生成的中间结果(如注意力状态)存储起来,以便在后续处理相似或相关输入时直接使用这些缓存结果,而无需重新计算。
这种方法不仅可以显著减少计算资源的消耗,还能加快响应时间,特别是在多轮对话或处理大文档时表现尤为突出。
2. prompt caching 的工作原理
Prompt caching 的工作原理主要包括以下几个步骤:
- 预计算注意力状态:
- 在首次处理输入时,模型会计算出一系列注意力状态,这些状态是模型理解和生成文本的关键中间结果。
- 存储注意力状态:
- 将这些计算出的注意力状态存储在缓存中,通常是一个高效的内存或磁盘存储系统。
- 复用缓存状态:
- 在后续处理相似或相关输入时,模型可以直接从缓存中读取之前存储的注意力状态,而无需重新计算。这不仅节省了计算资源,还加快了处理速度。
- 更新缓存:
- 根据需要,缓存中的注意力状态可以进行更新,以确保其在不断变化的对话或文档处理中保持有效。
通过这种方式,prompt caching 能够显著提高大型语言模型的效率,特别是在需要频繁处理相似输入的场景中。
3. 图表说明
以下图表展示了 prompt caching 的工作流程:
首次请求:
+------------------+       +------------------+
|  输入提示(A)   | ----> |  计算注意力状态  |
+------------------+       +------------------+
                                 |
                                 v
                         +------------------+
                         |  存储注意力状态  |
                         +------------------+

后续请求:
+------------------+       +------------------+
|  输入提示(A)   | ----> |  读取缓存状态    |
+------------------+       +------------------+
                                 |
                                 v
                         +------------------+
                         |  生成响应        |
                         +------------------+
4. 实际应用示例
4.1 示例:多轮对话中的 prompt caching
在多轮对话中,用户和模型之间的交互通常会涉及到重复的上下文信息。例如,在一个客户服务对话中,用户可能会多次提到相同的问题或背景信息。通过使用 prompt caching,可以显著提高对话的效率。
步骤如下:
4.1.1 首次对话
- 用户:我想了解一下我的订单状态。
- 模型:请提供您的订单号。
- 用户:订单号是 12345。
- 模型:好的,您的订单正在处理中,预计两天后到达。
4.1.2 缓存注意力状态
- 在上述对话中,模型计算出的注意力状态(如订单号 12345 的相关信息)被存储在缓存中。
4.1.3 后续对话
- 用户:我还想知道订单 12345 的详细信息。
- 模型:直接从缓存中读取订单 12345 的相关注意力状态,快速生成响应:您的订单包含一台笔记本电脑和一个鼠标,预计两天后到达。
5. 多轮对话图示
以下图表展示了多轮对话中 prompt caching 的应用:
首次对话:
+------------------+       +------------------+
|  用户:订单状态  | ----> |  模型:请提供订单号  |
+------------------+       +------------------+
                                 |
                                 v
+------------------+       +------------------+
|  用户:订单号 12345  | ----> |  模型:订单处理中  |
+------------------+       +------------------+
                                 |
                                 v
                         +------------------+
                         |  存储注意力状态  |
                         +------------------+

后续对话:
+------------------+       +------------------+
|  用户:订单详情  | ----> |  读取缓存状态    |
+------------------+       +------------------+
                                 |
                                 v
                         +------------------+
                         |  模型:订单详情  |
                         +------------------+
6. 总结
Prompt caching 的主要优点包括:
- 提高效率:通过复用先前计算的注意力状态,减少了重复计算的需求。
- 降低成本:减少了计算资源的消耗,特别是在处理大规模数据或多轮对话时。
- 加快响应速度:通过直接使用缓存结果,显著缩短了响应时间。