Llama Stack
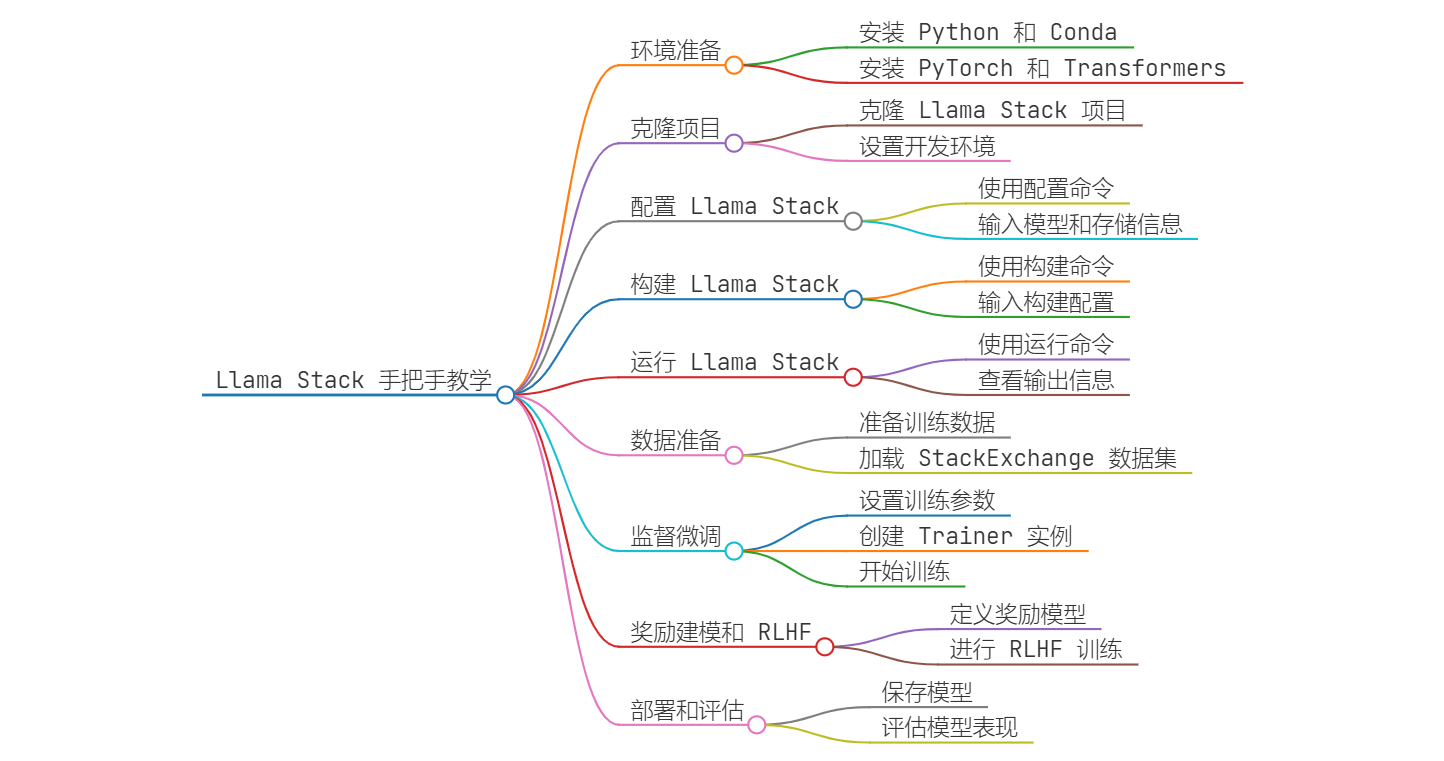
1- Llama Stack
1. 环境准备
首先,确保你的开发环境中已经安装了必要的软件和库。你可以使用以下命令来安装这些依赖项:
# 安装 Python 和 Conda
sudo apt-get update
sudo apt-get install python3 python3-pip
wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh
bash Miniconda3-latest-Linux-x86_64.sh

# 安装 PyTorch 和 Transformers
pip install torch transformers accelerate
1.1 1.1.1- 环境准备图示
+-------------------+       +-------------------+
|  |  |  |  |  |
|                           | 安装 Python 和 Conda         |                           | 安装 PyTorch 和 Transformers |                           |
|  |  |  |  |  |
+-------------------+       +-------------------+
2. 克隆 Llama Stack 项目
从 GitHub 克隆 Llama Stack 项目,并根据 README 文件中的指引设置开发环境:
git clone https://github.com/your-repo/llama-stack.git
cd llama-stack
2.1 1.2.1- 克隆项目图示
+-------------------+
|  |  |  |
|                   | 克隆 Llama Stack 项目 |                   |
|  |  |  |
+-------------------+
3. 配置 Llama Stack
使用 llama stack configure 命令来配置你的 Llama Stack 环境。以下是一个示例配置过程:
llama stack configure my-local-stack

# 系统将提示你输入以下信息:
# 模型名称(默认:Llama3.1-8B-Instruct)
# 是否配置量化(y/n)
# torch_seed(可选)
# 最大序列长度(默认:4096)
# 最大批处理大小(默认:1)
# 持久化存储类型(选项:redis, sqlite, postgres,默认:sqlite)
# 数据库路径(默认:/home/user/.llama/runtime/kvstore.db)
3.1 1.3.1- 配置 Llama Stack 图示
+-------------------+
|  |  |  |
|                | 配置 Llama Stack |                |
|  |  |  |
+-------------------+
4. 构建 Llama Stack
使用 llama stack build 命令来构建你的 Llama Stack 发行版:
llama stack build

# 系统将提示你输入构建配置:
# 发行版名称(例如:8b-instruct)
# 镜像类型(docker 或 conda,默认:conda)
# 各个 API 提供者(默认:meta-reference)
4.1 1.4.1- 构建 Llama Stack 图示
+-------------------+
|  |  |  |
|                | 构建 Llama Stack |                |
|  |  |  |
+-------------------+
5. 运行 Llama Stack
使用 llama stack run 命令来运行你的 Llama Stack:
llama stack run my-local-stack --port 5000

# 你将看到以下输出:
# > initializing model parallel with size 1
# > initializing ddp with size 1
# > initializing pipeline with size 1
# > Finished model load YES READY
# > Listening on :::5000
5.1 1.5.1- 运行 Llama Stack 图示
+-------------------+
|  |  |  |
|                | 运行 Llama Stack |                |
|  |  |  |
+-------------------+
6. 数据准备
在训练模型之前,需要准备好用于训练的数据。Llama Stack 通常使用 StackExchange 数据集,该数据集包含了 StackExchange 平台上的问题及其对应的答案。你可以从 Hugging Face 获取该数据集:
from datasets import load_dataset

# 加载 StackExchange 数据集
dataset = load_dataset('lvwerra/stack-exchange-paired')
6.1 1.6.1- 数据准备图示
+-------------------+
|  |  |  |
|      | 数据准备 |      |
|  |  |  |
+-------------------+
7. 监督微调 (SFT)
监督微调是训练模型的第一步,主要是通过有标签的数据来微调模型。以下是一个简单的监督微调示例:
from transformers import Trainer, TrainingArguments

# 设置训练参数
training_args = TrainingArguments(
    output_dir='./results',  # 输出目录
    num_train_epochs=3,  # 训练轮数
    per_device_train_batch_size=4,  # 每个设备的训练批次大小
    per_device_eval_batch_size=4,  # 每个设备的评估批次大小
    warmup_steps=500,  # 预热步数
    weight_decay=0.01,  # 权重衰减
    logging_dir='./logs',  # 日志目录
)

# 创建 Trainer 实例
trainer = Trainer(
    model=model,  # 训练的模型
    args=training_args,  # 训练参数
    train_dataset=dataset['train'],  # 训练数据集
    eval_dataset=dataset['validation']  # 验证数据集
)

# 开始训练
trainer.train()
7.1 1.7.1- 监督微调图示
+-------------------+
|  |  |  |
|      | 监督微调 |      |
|  |  |  |
+-------------------+
8. 奖励建模 (RM) 和人类反馈的强化学习 (RLHF)
在监督微调之后,可以进行奖励建模和人类反馈的强化学习。这一步主要是通过人类反馈来进一步优化模型的表现。以下是一个简单的 RLHF 示例:
from trl import PPOTrainer

# 定义奖励模型和 PPO 训练器
reward_model = ...  # 你的奖励模型
ppo_trainer = PPOTrainer(model=model, reward_model=reward_model, ...)

# 进行 RLHF 训练
ppo_trainer.train()
8.1 1.8.1- 奖励建模和 RLHF 图示
+-------------------+
|  |  |  |
|            | 奖励建模和 RLHF |            |
|  |  |  |
+-------------------+
9. 部署和评估
训练完成后,可以将模型部署到生产环境中,并进行评估。Llama Stack 提供了标准化的 API,方便开发者在不同环境中部署和调用模型。
# 部署模型
model.save_pretrained('path_to_save_model')

# 评估模型
results = trainer.evaluate()
print(results)
9.1 1.9.1- 部署和评估图示
+-------------------+
|  |  |  |
|       | 部署和评估 |       |
|  |  |  |
+-------------------+
通过以上步骤和图表,你可以完成 Llama Stack 的详细使用流程,从环境准备、模型加载、数据准备、训练到部署和评估。