Instruction Tuning
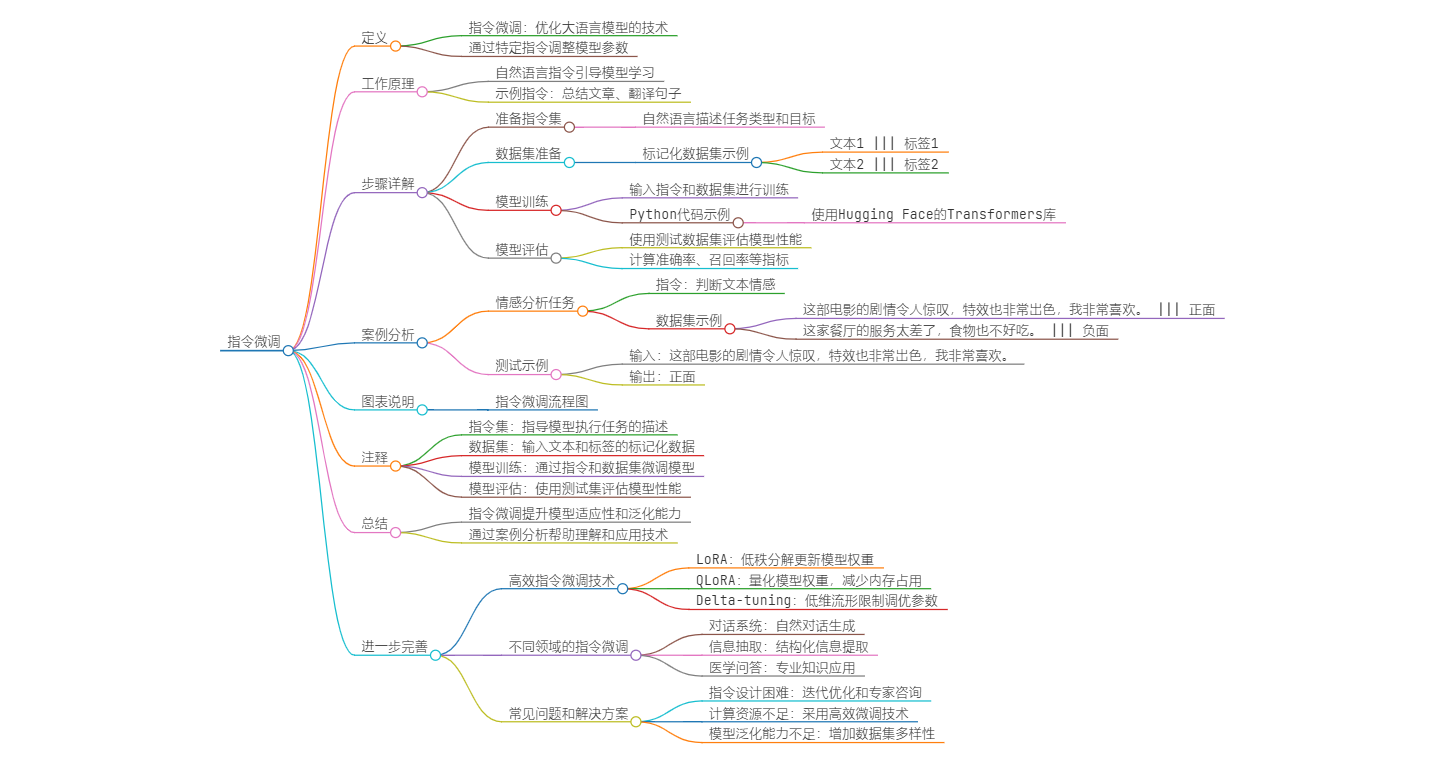
Instruction Tuning(指令微调)是一种用于优化大语言模型(LLMs)的技术,通过提供特定的指令或提示来调整模型的参数,以提高其在特定任务上的表现。
1. 工作原理
指令微调的核心在于通过一组明确的指令或提示来引导模型学习特定任务。
这些指令可以是自然语言形式的描述,告诉模型需要完成什么任务以及如何完成。
例如,指令可以是"请总结这篇文章的主要观点"或"将以下句子翻译成法语"。
2. 步骤详解
2.1. 准备指令集
首先,为特定任务准备一组自然语言指令。
这些指令详细描述了任务的类型和目标。
例如,对于情感分析任务,指令可以是"请判断以下文本的情感是正面、负面还是中性"。
2.2. 数据集准备
准备一个标记化的数据集,其中每个数据样本都包含输入文本和相应的标签。例如:
文本1 | 标签1
文本2 | 标签2
文本3 | 标签3
2.3. 模型训练
将自然语言指令和数据集输入模型进行训练,模型将学习如何根据指令执行任务。
以下是一个简单的 Python 代码示例,使用 Hugging Face 的 Transformers 库进行指令微调:
from transformers import GPT2Tokenizer, GPT2LMHeadModel, Trainer, TrainingArguments

# 加载预训练模型和分词器
tokenizer = GPT2Tokenizer.from_pretrained('gpt2')
model = GPT2LMHeadModel.from_pretrained('gpt2')

# 准备数据集
train_texts = ["这部电影的剧情令人惊叹,特效也非常出色,我非常喜欢。 | 正面",
               "这家餐厅的服务太差了,食物也不好吃。 | 负面"]
train_encodings = tokenizer(train_texts, truncation=True, padding=True, max_length=512)

# 定义训练参数
training_args = TrainingArguments(
    output_dir='./results',
    num_train_epochs=3,
    per_device_train_batch_size=2,
    save_steps=10,
    save_total_limit=2,
)

# 创建Trainer实例
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_encodings,
)

# 开始训练
trainer.train()
2.4. 模型评估
使用测试数据集评估模型的性能,确保其能够准确执行指令。
例如,输入文本并观察模型生成的情感标签,然后与实际标签进行比较,计算准确率、召回率等性能指标。
3. 案例分析
3.1. 情感分析任务
指令:请判断以下文本的情感是正面、负面还是中性。
数据集示例:
这部电影的剧情令人惊叹,特效也非常出色,我非常喜欢。 | 正面
这家餐厅的服务太差了,食物也不好吃。 | 负面
训练过程:
- 准备指令和数据集:如上所示。
- 模型训练:使用上述 Python 代码进行训练。
- 模型评估:输入新的文本,观察模型的输出。
测试示例:
输入:这部电影的剧情令人惊叹,特效也非常出色,我非常喜欢。
输出:正面
4. 图表说明
4.1. 指令微调流程图
+------------------+       +------------------+       +------------------+
|    准备指令集     | ----> |    准备数据集     | ----> |     模型训练      |
+------------------+       +------------------+       +------------------+
                                                           |
                                                           v
                                                   +------------------+
                                                   |     模型评估      |
                                                   +------------------+
5. 注释
- 指令集:用于指导模型执行特定任务的自然语言描述。
- 数据集:包含输入文本和相应标签的标记化数据。
- 模型训练:通过指令和数据集对模型进行微调。
- 模型评估:使用测试数据集评估模型性能。
6. 总结
指令微调是一种强大的技术,通过自然语言指令引导大语言模型学习和执行任务,显著提高了模型的适应性和泛化能力。
通过本文的详细介绍和案例分析,希望小白用户能够更好地理解和应用指令微调技术。
7. 进一步完善
为了进一步完善本文内容,我们可以增加以下几个方面:
7.1. 高效指令微调技术
高效指令微调技术的主要目的是在减少计算资源和时间的情况下,达到良好的微调效果。
常见的方法包括:
- LoRA(Low-Rank Adaptation):通过将模型权重分解为低秩分量进行更新,减少参数量和计算内存。
- QLoRA:对模型权重进行量化,只调整低秩适配器参数,进一步减少内存占用。
- Delta-tuning:将调优参数限制在低维流形上,提供理论分析和参数高效性。
7.2. 不同领域的指令微调
指令微调在不同领域的应用需求和挑战各不相同。
以下是几个典型领域的应用案例:
- 对话系统:使模型进行自然对话,理解长序列语义联系,生成连贯回复。
- 信息抽取:从文本中提取结构化信息,处理不同规范的信息抽取任务。
- 医学问答:需要专业医学知识,避免错误信息,在医学知识图谱上进行指令调优。
7.3. 常见问题和解决方案
在实际应用中,指令微调可能会遇到一些常见问题,例如:
- 指令设计困难:设计高质量的指令需要经验和技巧,可以通过迭代优化和专家咨询来改进。
- 计算资源不足:可以采用高效微调技术,如 LoRA 和 QLoRA,减少计算资源需求。
- 模型泛化能力不足:通过增加指令数据集的多样性和覆盖范围,提高模型的泛化能力。
通过以上内容的补充和完善,希望能够为读者提供更全面和深入的指令微调知识,帮助大家更好地理解和应用这一技术。