huggingface
网址:hugging face
Hugging Face 是一个致力于推进自然语言处理(NLP)技术和工具发展的开源社区和公司。
他们提供了各种 NLP 任务中的最新技术、模型和工具,并为开发者提供便捷的方式来使用、微调和部署这些技术。
Hugging Face 在 NLP 领域中的贡献得到了广泛认可,成为了许多开发者和研究者的重要资源。除了自然语言处理,还支持处理图像和音频等多模态任务,社区还提供海量的预训练模型和数据集。
1. 主要功能
1.1. 模型库
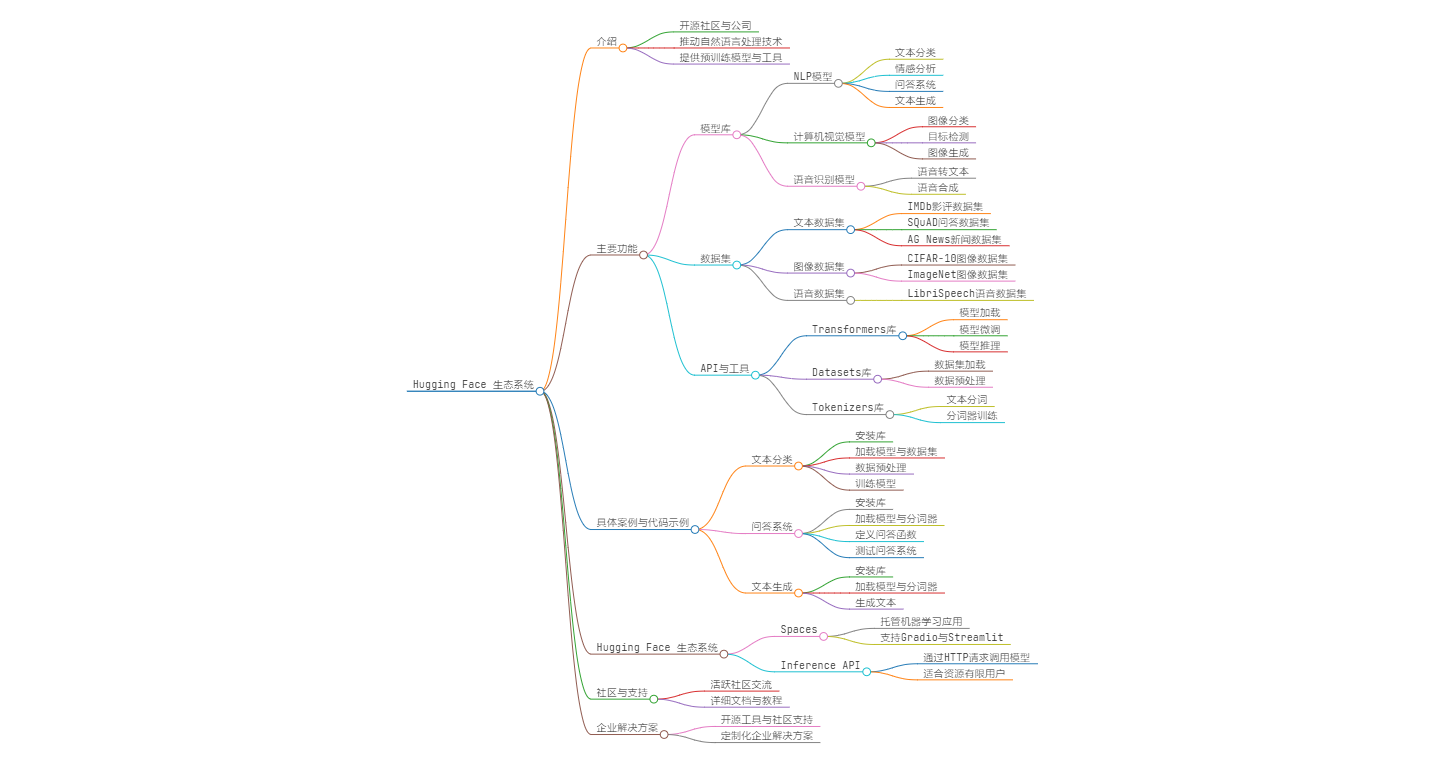
Hugging Face 提供了一个庞大的模型库,用户可以在其中找到各种预训练模型,包括自然语言处理(NLP)、计算机视觉和语音识别等领域的模型。
以下是 Hugging Face 模型库的结构图:
+----------------------------+
| Hugging Face 模型库        |
+----------------------------+
| NLP 模型                   |
| - 文本分类                 |
| - 情感分析                 |
| - 问答系统                 |
| - 文本生成                 |
+----------------------------+
| 计算机视觉模型             |
| - 图像分类                 |
| - 目标检测                 |
| - 图像生成                 |
+----------------------------+
| 语音识别模型               |
| - 语音转文本               |
| - 语音合成                 |
+----------------------------+
1.2. 数据集
Hugging Face 平台上托管了大量公开数据集,供用户下载和使用,以便进行模型训练和评估。
以下是 Hugging Face 数据集库的结构图:
+----------------------------+
| Hugging Face 数据集库      |
+----------------------------+
| 文本数据集                 |
| - IMDb 影评数据集          |
| - SQuAD 问答数据集         |
| - AG News 新闻数据集       |
+----------------------------+
| 图像数据集                 |
| - CIFAR-10 图像数据集      |
| - ImageNet 图像数据集      |
+----------------------------+
| 语音数据集                 |
| - LibriSpeech 语音数据集   |
+----------------------------+
1.3. API 和工具
Hugging Face 提供了多种 API 和工具,如 Transformers 库、Datasets 库和 Tokenizers 库,帮助用户更方便地进行模型开发和数据处理。
以下是 Hugging Face 工具的结构图:
+----------------------------+
| Hugging Face 工具          |
+----------------------------+
| Transformers 库            |
| - 模型加载                 |
| - 模型微调                 |
| - 模型推理                 |
+----------------------------+
| Datasets 库                |
| - 数据集加载               |
| - 数据预处理               |
+----------------------------+
| Tokenizers 库              |
| - 文本分词                 |
| - 分词器训练               |
+----------------------------+
2. 具体案例和代码示例
2.1. 案例一:文本分类
文本分类是自然语言处理中的一个基本任务。以下是使用 Hugging Face 的 Transformers 库进行文本分类的一个简单示例。
2.2. 步骤 1:安装必要的库
pip install transformers datasets torch
2.3. 步骤 2:加载预训练模型和数据集
from transformers import AutoTokenizer, AutoModelForSequenceClassification
from datasets import load_dataset

# 加载预训练的 BERT 模型和分词器
model_name = "bert-base-uncased"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# 加载 IMDb 数据集
dataset = load_dataset("imdb")
2.4. 步骤 3:数据预处理
def preprocess_function(examples):
    return tokenizer(examples['text'], padding="max_length", truncation=True)

# 对数据集进行分词处理
encoded_dataset = dataset.map(preprocess_function, batched=True)
2.5. 步骤 4:训练模型
from transformers import TrainingArguments, Trainer

# 设置训练参数
training_args = TrainingArguments(
    output_dir="./results",
    evaluation_strategy="epoch",
    learning_rate=2e-5,
    per_device_train_batch_size=16,
    per_device_eval_batch_size=16,
    num_train_epochs=3,
    weight_decay=0.01,
)

# 初始化 Trainer
trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=encoded_dataset["train"],
    eval_dataset=encoded_dataset["test"],
)

# 开始训练
trainer.train()
2.6. 案例二:问答系统
问答系统是另一个常见的 NLP 应用。以下是使用 Hugging Face 的 Transformers 库构建一个简单问答系统的示例。
2.7. 步骤 1:安装必要的库
pip install transformers torch
2.8. 步骤 2:加载预训练模型和分词器
from transformers import AutoTokenizer, AutoModelForQuestionAnswering

# 加载预训练的 BERT 问答模型和分词器
model_name = "bert-large-uncased-whole-word-masking-finetuned-squad"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForQuestionAnswering.from_pretrained(model_name)
2.9. 步骤 3:定义问答函数
import torch

def answer_question(question, context):
    inputs = tokenizer.encode_plus(question, context, return_tensors="pt")
    input_ids = inputs["input_ids"].tolist()

    # 获取模型输出
    outputs = model(**inputs)
    answer_start_scores = outputs.start_logits
    answer_end_scores = outputs.end_logits

    # 获取答案的起始和结束位置
    answer_start = torch.argmax(answer_start_scores)
    answer_end = torch.argmax(answer_end_scores) + 1

    # 将答案的 token 转换为字符串
    answer = tokenizer.convert_tokens_to_string(tokenizer.convert_ids_to_tokens(input_ids[answer_start:answer_end]))
    return answer
2.10. 步骤 4:测试问答系统
context = "Hugging Face 是一个致力于推进和民主化人工智能的开源社区和平台。"
question = "Hugging Face 是什么?"

answer = answer_question(question, context)
print(f"问题: {question}")
print(f"答案: {answer}")
2.11. 案例三:文本生成
文本生成是使用预训练语言模型生成类似人类文本的任务。以下是使用 GPT-2 模型进行文本生成的示例。
2.12. 步骤 1:安装必要的库
pip install transformers torch
2.13. 步骤 2:加载预训练模型和分词器
from transformers import AutoTokenizer, AutoModelForCausalLM

# 加载预训练的 GPT-2 模型和分词器
model_name = "gpt2"
tokenizer = AutoTokenizer.from_pretrained(model_name)
model = AutoModelForCausalLM.from_pretrained(model_name)
2.14. 步骤 3:生成文本
input_text = "Once upon a time"
input_ids = tokenizer.encode(input_text, return_tensors="pt")

# 生成文本
output = model.generate(input_ids, max_length=50, num_return_sequences=1)

# 将生成的 token 转换为字符串
generated_text = tokenizer.decode(output, skip_special_tokens=True)
print(generated_text)
3. Hugging Face 的生态系统
3.1. Spaces
Hugging Face Spaces 是一个托管机器学习应用的服务,用户可以在上面展示和分享他们的模型和应用。Spaces 支持多种框架,包括 Gradio 和 Streamlit,使得用户可以快速构建和部署交互式的机器学习应用。
3.2. 示例:使用 Gradio 创建一个简单的文本分类应用
import gradio as gr
from transformers import pipeline

# 加载预训练的文本分类模型
classifier = pipeline("sentiment-analysis")

# 定义预测函数
def classify_text(text):
    return classifier(text)

# 创建 Gradio 接口
iface = gr.Interface(fn=classify_text, inputs="text", outputs="label")

# 启动应用
iface.launch()
3.3. Inference API
Hugging Face 提供了 Inference API,允许用户通过简单的 HTTP 请求调用预训练模型进行推理。这对于没有足够计算资源进行本地部署的用户非常有用。
3.4. 示例:使用 Inference API 进行文本生成
import requests

API_URL = "https://api-inference.huggingface.co/models/gpt2"
headers = {"Authorization": "Bearer YOUR_HUGGING_FACE_API_KEY"}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload)
    return response.json()

data = query({"inputs": "Once upon a time"})
print(data)
4. 社区与支持
Hugging Face 拥有一个活跃的社区,用户可以在论坛、GitHub 和社交媒体上交流经验、分享资源和寻求帮助。
Hugging Face 还提供了详细的文档和教程,帮助用户快速上手。
5. Hugging Face 的企业解决方案
除了开源工具和社区支持,Hugging Face 还提供了一系列企业级解决方案,帮助企业更高效地管理和部署机器学习模型。
5.1. Private Hub
Private Hub 是一个私有的模型托管平台,适用于需要高安全性和隐私保护的企业用户。它允许企业在一个安全的环境中存储和管理他们的模型,确保数据和模型的隐私性。
5.2. AutoNLP
AutoNLP 是一个自动化的 NLP 模型训练和部署平台,简化了机器学习工作流程。它可以自动选择最佳模型架构、优化超参数,并生成高性能的 NLP 模型,适用于没有深厚机器学习背景的用户。
5.3. Inference API
Hugging Face 提供了 Inference API,允许用户通过简单的 HTTP 请求调用预训练模型进行推理。这对于没有足够计算资源进行本地部署的用户非常有用。Inference API 基于使用量收费,适用于需要高效、低成本推理服务的企业。
5.4. 企业定制解决方案
对于企业级客户,Hugging Face 提供了定制化的解决方案,包括私有模型托管、端到端机器学习平台支持等。这些服务通常会根据企业的需求和使用情况来确定价格,确保企业能够获得最适合的解决方案。
6. 总结
Hugging Face 是一个功能强大且资源丰富的平台,适合各种层次的用户,从初学者到高级研究人员。
它不仅提供了丰富的工具和资源,还通过其活跃的社区促进了知识共享和技术进步。
无论是进行文本分类、问答系统还是文本生成,Hugging Face 都能提供相应的解决方案和支持。