FireCrawl
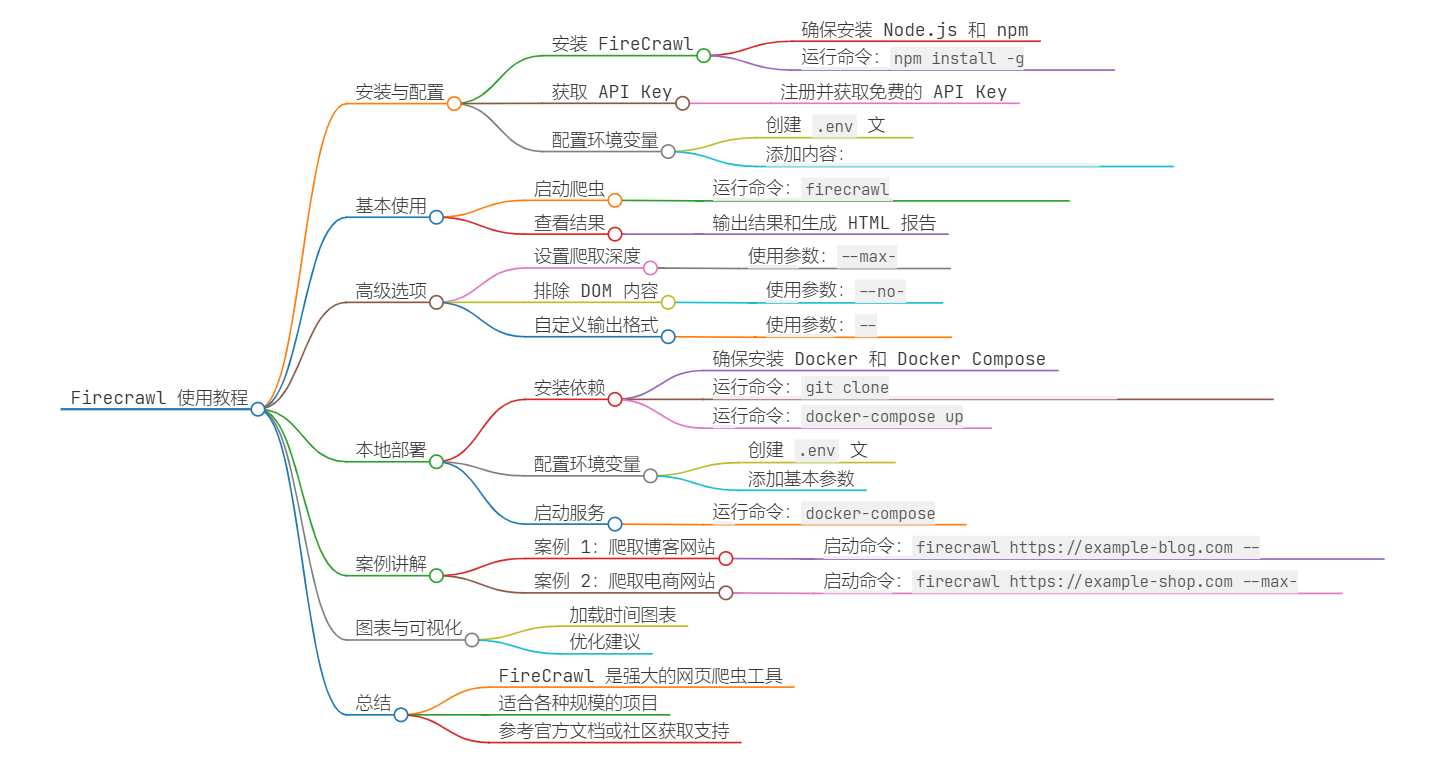
1. FireCrawl
FireCrawl 是一款强大的网页爬虫工具,能够将网站内容转换为适合大语言模型(LLM)使用的 Markdown 或结构化数据。
文档:doc
2. 安装与配置
2.1. 安装 FireCrawl
首先,确保你已经安装了 Node.js 和 npm。然后在命令行中运行以下命令来全局安装 FireCrawl:
npm install -g firecrawl-cli
此命令会全局安装 FireCrawl 命令行工具。
2.2. 获取 API Key
访问 FireCrawl 的官方网站,注册并获取免费的 API Key。你需要将这个 API Key 配置到环境变量中。
官网:链接
2.3. 配置环境变量
在项目根目录下创建一个 .env 文件,并添加以下内容:
FIRECRAWL_API_KEY=your_api_key_here
将 your_api_key_here 替换为你实际的 API Key。
2.3.1. API Key
<YOUR_FIRECRAWL_API_KEY>
[!NOTE]
示例中的 Key 为临时注册所得,可能有有效期,请替换为你自己的 API Key
3. 基本使用
3.1. 启动爬虫
在命令行中运行以下命令,开始抓取指定网址:
firecrawl https://example.com
此命令会抓取 https://example.com 单个页面并输出 Markdown 结果。若要抓取整站的所有子页面,请使用 crawl 命令。
3.2. 查看结果
抓取完成后,FireCrawl 会在终端输出转换后的结果,并自动保存到当前目录的 .firecrawl/ 文件夹中。你也可以通过 -o 参数指定输出文件,方便进一步查看和处理。
4. 高级选项
FireCrawl 提供了多种高级选项,帮助用户进行更深入的定制化抓取。
4.1. 设置爬取深度
你可以通过 --max-depth 参数设置爬取的深度。例如:
firecrawl crawl https://example.com --max-depth 3
此命令会设置爬取深度为 3 层。
4.2. 只提取正文内容
如果你只需要页面的正文内容,可以使用 --only-main-content 参数:
firecrawl https://example.com --only-main-content
此参数会自动去除导航栏、页脚等无关元素,只保留正文内容。
4.3. 自定义输出格式
FireCrawl 支持多种输出格式,如 Markdown、HTML、原始 HTML 等。你可以通过 --format 参数指定需要的格式:
firecrawl https://example.com --format markdown,html
此命令会将爬取结果同时输出为 Markdown 和 HTML 格式(指定多种格式时会以 JSON 形式返回)。
5. 本地部署
如果你希望在本地环境中运行 FireCrawl,可以按照以下步骤进行配置:
5.1. 安装依赖
确保你已经安装了 Docker 和 Docker Compose。然后克隆 FireCrawl 的 GitHub 仓库:
git clone https://github.com/mendableai/firecrawl.git
cd firecrawl
此命令会克隆 FireCrawl 仓库。
5.2. 配置环境变量
在 /apps/api/ 目录下创建 .env 文件,并添加以下内容:
NUM_WORKERS_PER_QUEUE=8
PORT=3002
HOST=0.0.0.0
REDIS_URL=redis://localhost:6379
REDIS_RATE_LIMIT_URL=redis://localhost:6379
USE_DB_AUTHENTICATION=false
此配置文件设置了 FireCrawl 服务的基本参数。
5.3. 启动服务
运行以下命令启动 FireCrawl 服务:
docker-compose up -d
此命令会在后台启动 FireCrawl 服务。
6. 案例讲解
6.1. 案例 1:爬取博客网站
假设你想爬取一个博客网站 https://example-blog.com,并将内容转换为 Markdown 格式。你可以按照以下步骤操作:
6.1.1. 启动爬虫
firecrawl scrape https://example-blog.com --format markdown
此命令会抓取博客网站并将内容转换为 Markdown 格式。
6.1.2. 查看结果
FireCrawl 会在终端输出爬取进度,并将转换后的结果保存到当前目录的 .firecrawl/ 文件夹中。你可以在该文件夹中找到转换后的 Markdown 文件。
6.2. 案例 2:爬取电商网站
假设你想爬取一个电商网站 https://example-shop.com,并将产品页面转换为 Markdown 数据。你可以按照以下步骤操作:
6.2.1. 启动爬虫
firecrawl crawl https://example-shop.com --max-depth 2
此命令会爬取电商网站并设置爬取深度为 2 层。
6.2.2. 查看结果
FireCrawl 会在终端输出爬取进度,并将各页面的转换结果保存到 .firecrawl/ 文件夹中。你可以在编辑器中打开这些 Markdown 文件,查看提取到的产品信息。
6.3. 结构化输出与可视化
FireCrawl 的爬取结果可以直接用于数据分析与可视化。例如:
- 结构化数据:通过
--format json参数输出 JSON 格式,便于程序处理和绘制图表。 - 页面截图:通过
--screenshot参数获取页面截图,用于留存页面快照或辅助分析。
7. 总结
FireCrawl 是一款功能强大且灵活的网页爬虫工具,适合各种规模的项目。通过上述步骤,你可以轻松安装、配置并使用 FireCrawl 进行网页数据的抓取和分析。如果你需要更多帮助,可以参考 FireCrawl 的官方文档或加入其社区获取支持。