AI与AI安全:如何快速 hack 开源模型?
1. 提示词注入原理
简单以打比方的形式讲一下原理,如果了解大模型注入原理的读者可以不看这一节。
大家有没有参加过数学建模比赛?就是那个采集数据,然后把它们拉到一条曲线上的比赛。
实际上,AI 的工作原理跟这个建模比赛的原理有些类似之处(具体的原理和运算过程我们在第一节中提过)——我们知道当前主流 LLM 的原理是"根据文字生文字",在 LLM 的工作过程中,用户输入的每个词被当做一个向量来表示,LLM 会根据我们输入的所有词来对后续词汇进行预测,直到段落输出结束。
这里就存在一个很大的问题:在 LLM 训练完成之后,如果我们要给 LLM 添加功能、设定角色,这些功能和角色也需要和用户的输入放在一起,被一并输入至 LLM。而 LLM 无法判断哪一部分输入是系统的,哪一部分输入是用户的。
听起来是不是很耳熟?在传统安全中,以"用户输入"和"系统指令"的不清为攻击面而形成的攻击类型并非第一次出现。传统安全中一系列以注入为核心的漏洞如 SQL 注入和 SSRF、XSS 都算是其中一员。
📌 说明: 上下文机制虽然和提示词注入漏洞直接相关,但提示词注入这个漏洞本身是一个大类,手法比较多,一些本文中没有提到的手法会另行讲解。
2. 上下文机制
在实际讲解提示词注入手法之前,我们需要先了解一下 LLM 的上下文机制。
首先,各位读者应该都能隐隐约约把上下文跟"历史对话"关联到一起,并且事实上,这确实是上下文机制的核心原理。
假设我们在和部署在云端的 LLM 对话,在每轮次对话中:
- 我们输入的内容会以文字的形式被上传到云端
- 本轮次输入会被以特定格式与历史问答内容(请把与 LLM 交互的过程想象为写一本永不完结的书)拼接到一起,然后输入到 LLM 里
那么这里就有一个很关键的问题:用户、LLM(和系统)几方的输入之间是怎么拼接的,拼接格式是什么样的?
2.1. Chat Template
说到拼接格式,就要了解 chat template。大部分 LLM 在训练阶段都会被规定一个固定的模式规则,或者说,对于同一个 LLM 的训练数据必定要倾向于有一个固定的格式——如果训练者预期一个足够好的训练结果。
我们拿 DeepSeek-R1 举例。它的拼接格式可以在 Hugging Face 社区或者 Ollama 里找到。
以下是 DeepSeek-R1 的 Hugging Face 页面:
我们可以通过查看模型的 tokenizer_config.json 文件以寻找 template:
它的语法 template 是用 Jinja2 写的,如下:
{%- if not add_generation_prompt is defined -%}
	{%- set add_generation_prompt = false -%}
{%- endif -%}
{%- set ns = namespace(is_first=false, is_tool=false, is_output_first=true, system_prompt="", is_first_sp=true) -%}
{%- for message in messages -%}
	{%- if message["role"] == "system" -%}
		{%- if ns.is_first_sp -%}
			{%- set ns.system_prompt = ns.system_prompt + message["content"] -%}
			{%- set ns.is_first_sp = false -%}
		{%- else -%}
			{%- set ns.system_prompt = ns.system_prompt + "\n\n" + message["content"] -%}
		{%- endif -%}
	{%- endif -%}
{%- endfor -%}
{{- bos_token -}}
{{- ns.system_prompt -}}
...
其中变量的值在文件上面被定义:

按照上面的模版,则一条处理完毕后的提示词示例长这样:
<|begin▁of▁sentence|>系统提示

  <|User|>用户输入

<|Assistant|>
  <|tool▁calls▁begin|>
    <|tool▁call▁begin|>function
    <|tool▁sep|>工具名称
      ```json
      {"参数": "工具参数概括"}
      ```
    <|tool▁call▁end|>
  <|tool▁calls▁end|><|end▁of▁sentence|>

<|tool▁outputs▁begin|>
  <|tool▁output▁begin|>
    工具输出
  <|tool▁output▁end|>
<|tool▁outputs▁end|>

<|User|>用户追问

<|Assistant|>助手回复<|end▁of▁sentence|>
3. 利用 Chat Template 注入开源模型
由于开源模型的 chat_template 基本都已知,所以针对 chat_template 制作的 POC 对开源模型有额外的效果。
还是用 DeepSeek 做演示。
经过测试,大多数 chat template 中的内容对商业部署的 DeepSeek 有效。
3.1. 系统提示词注入
虽然 DeepSeek 中没有专门的系统提示词标签(这也导致大部分系统提示词标签类型的提示词注入对 DeepSeek 没什么用),但看 chat template 中可以看到规定的系统提示词在 bos_token 也就是 <|begin▁of▁sentence|> 后:
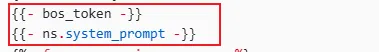
所以我们可以把 payload 放在这个标志后进行注入:

3.2. 其它标签利用
这里的利用范围绝对比我写的要广,比如说——tool 调用也是可以注入的。
可以用 think 标签伪装 LLM 思考过程。

这个 payload 我称之为天地同豆,欧耶。
同时,由于用户的对话会在上下文被压缩之前持续存在,即使 LLM 在第一段对话中识破了用户的意图——在后文中,用户曾使用的 payload 仍然会对 LLM 产生影响:

4. 最后
本文内容我在 B 站上做过演示。
文章中注入的模型是在线的 DeepSeek(腾讯元宝/深度求索),演示中注入的是 Qwen(自行部署/阿里)。
AI 与 AI 安全 2:chat_template 是如何成为开源模型注入的一大利器?
ds 那个问题忘记解答了。不过也没啥好说的。