URL智能读取SKILL:一键抓取任何网站内容并自动同步到Obsidian作为素材
URL智能读取SKILL:一键抓取任何网站内容并自动同步到Obsidian作为素材
卧槽!!!今天必须给大家分享一个我刚做完的神器!!!
一个能读取任何网站内容的工具,微信公众号、小红书、知乎、抖音、淘宝、京东…全都能抓!!!
而且自动保存成Markdown并同步到Obsidian,图片也全部下载到本地!!!
1. 为什么要做这个?
每次看到好文章想保存,要么复制粘贴格式全乱,要么图片全是外链过几天就挂了。
微信公众号更离谱,复制出来全是乱码!!!
所以我就想:能不能做一个工具,输入URL就自动把内容和图片全部抓下来?
答案是:能!而且特么的超简单!!!
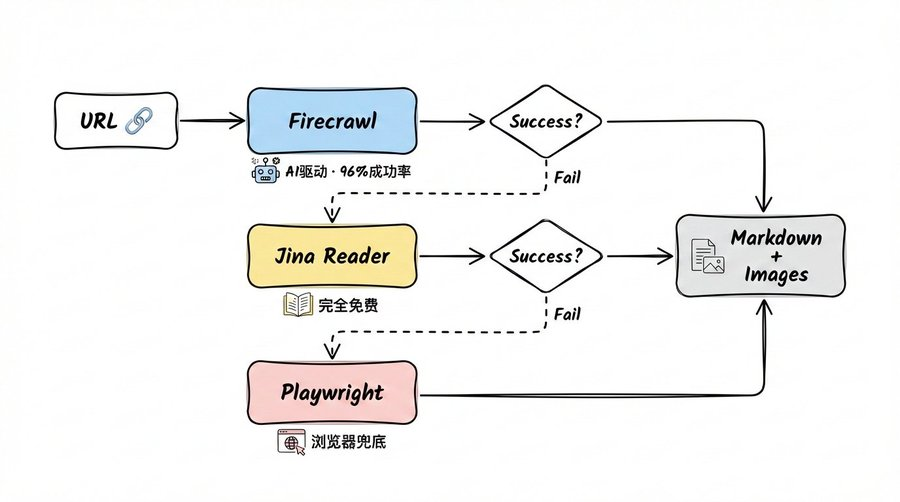
2. 核心思路:三层策略自动降级
这个工具的核心就是三层策略:
Firecrawl(首选)→ Jina(备选)→ Playwright(兜底)
为什么要三层?因为没有一个方案能搞定所有网站!!!
- Firecrawl:AI驱动,能搞定 96% 的网站,但要钱(免费 500 页/月);闲鱼有 8 万积分,很便宜。
- Jina:完全免费,但有些网站搞不定
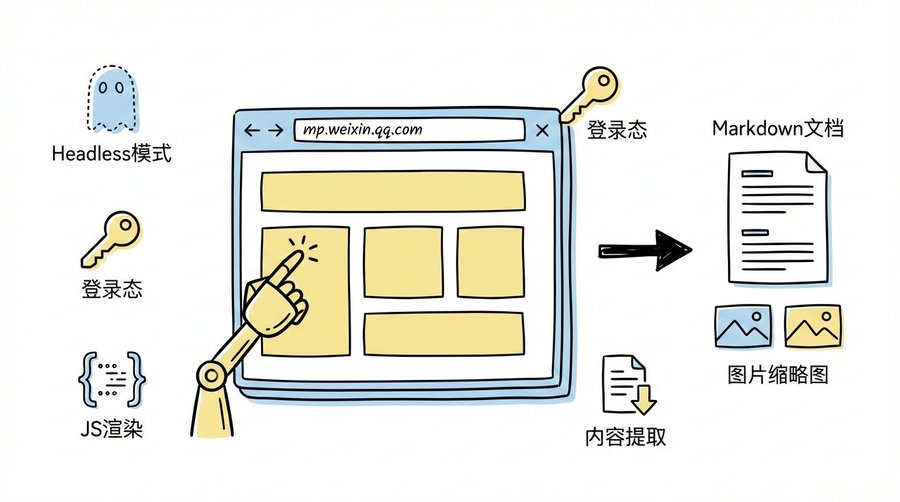
- Playwright:浏览器自动化,什么都能搞,但需要登录态
三层组合,基本上能搞定 99% 的网站!!!
3. 第一步:平台识别
首先要识别URL是哪个平台的,这样才能选择最佳策略。
让AI写代码的Prompt:
帮我写一个Python函数,输入URL,识别是哪个平台:
- 微信公众号:mp.weixin.qq.com
- 小红书:xiaohongshu.com, xhslink.com
- 知乎:zhihu.com
- 抖音:douyin.com
- 淘宝:taobao.com
- 京东:jd.com
- B站:bilibili.com
返回平台名称和是否需要登录
AI会给你一个完美的 identify_platform() 函数!
4. 第二步:Firecrawl策略
Firecrawl是一个AI驱动的网页抓取API,牛逼的地方在于:
- 自动处理JavaScript渲染
- 自动绕过反爬机制
- 直接返回干净的Markdown
让AI写代码的Prompt:
帮我写一个用Firecrawl抓取网页的函数:
1. 从环境变量读取FIRECRAWL_API_KEY
2. 调用firecrawl-py库的scrape方法
3. 注意:Firecrawl v2返回的是Document对象,不是dict
4. 用getattr获取markdown和metadata
5. 检查内容是否有效(长度>100,不是验证页面)
踩坑提醒:Firecrawl v2的返回值变了!!!
以前是 result.get('markdown'),现在要用 getattr(result, 'markdown', '')!!!
这个坑我踩了半小时才发现…
5. 第三步:Jina策略
Jina Reader是完全免费的!!!用法超简单:
https://r.jina.ai/{你的URL}
直接在URL前面加上https://r.jina.ai/就行!
让AI写代码的Prompt:
帮我写一个用Jina Reader读取网页的函数:
6. 在URL前面加上https://r.jina.ai/
7. 设置Accept: text/markdown
8. 设置User-Agent模拟浏览器
9. 检查返回内容是否有效
6. 第四步:Playwright策略
这是兜底方案,用真实浏览器去访问页面。
让AI写代码的Prompt:
帮我写一个用Playwright读取网页的函数:
10. 使用async_playwright
11. 启动chromium浏览器(headless模式)
12. 设置微信内置浏览器的User-Agent
13. 支持加载已保存的登录态(storage_state)
14. 等待页面加载完成后提取内容
15. 用page.evaluate执行JS提取标题和正文
踩坑提醒:微信公众号的长链接(带 __biz 参数的)容易触发验证!!!
短链接(/s/xxxxx 格式)更稳定!
7. 第五步:内容保存及同步
抓到内容后,要保存成Markdown并下载图片同时保存到Obsidian。
只需要指定内容保存到某个目录,然后再到Obsidian把这个目录添加进去就可以了。
让AI写代码的Prompt:
帮我写一个保存内容的函数:
16. 从内容中提取标题
17. 创建目录:日期_标题
18. 用正则提取所有图片URL(支持Markdown格式、直接URL、小红书图片、飞书图片)
19. 下载图片到本地,命名为img_01.jpg等
20. 把内容中的图片URL替换成本地路径
21. 保存为content.md,带上元数据(标题、来源、时间)
踩坑提醒:下载小红书图片要设置Referer头!!!
headers = {
    'User-Agent': 'Mozilla/5.0...',
    'Referer': 'https://www.xiaohongshu.com/'
}
不然会403!
8. 踩坑总结
- Firecrawl v2返回值变了:用
getattr()不要用.get() - 微信长链接触发验证:用短链接更稳定
- 标题提取要跳过元数据:第一行可能是「来源:xxx」不是标题
- 图片下载要设Referer:不同平台要设不同的Referer
9. 成本计算
- Firecrawl:免费 500 页/月,够用了
- Jina:完全免费
- Playwright:免费,但需要安装 Chromium(约 200 MB)
- 总成本:0 元!!!
10. 变现方向
- 内容采集服务:帮自媒体批量采集素材
- 竞品监控:监控竞争对手的公众号/小红书
- 数据分析:采集行业内容做分析报告
- 知识库建设:自动采集整理行业知识
11. 最后
这个工具我后面会开源,现在还在优化中,接下来会做批量抓取,同时会结合其他 skill,做更多的二创内容。
11.1 网址
12. 读取并保存
用法超简单:
python url_reader.py https://mp.weixin.qq.com/s/xxxxx --save
内容和图片自动保存到本地!!!