索尼开源 AI 模型 Woosh:一句话生成音效,一键为视频配音
1. 索尼开源 AI 模型 Woosh:一句话生成音效,一键为视频配音
[!abstract] 本文要点
索尼人工智能研究院(Sony AI)发布的音效生成基础模型。
1.1. 项目定位
Woosh 是专为音效生成(Sound Effects)优化的多模态生成式 AI 模型套件,旨在为音频研究社区提供高质量的开源基座模型,支持**文本到音频(T2A)和视频到音频(V2A)**两大核心任务。
🔗 技术报告:arXiv:2604.01929
1.2. 核心模块组成
1.2.1. Woosh-AE:音频编码器/解码器
| 特性 | 说明 |
|---|---|
| 功能 | 高质量潜在空间编码与解码,为生成模型提供压缩表示 |
| 采样率 | 48 kHz,支持高保真音频重建 |
| 压缩比 | 约 3.75×,在保留细节的同时显著降低计算负载 |
| 优势 | 相比 Stable Audio Open 等基线,在频谱重建和听感质量上表现更优 |
1.2.2. Woosh-CLAP:文本-音频对齐模型
| 特性 | 说明 |
|---|---|
| 功能 | 多模态对比学习,实现文本描述与音频片段的语义对齐 |
| 作用 | 为扩散模型提供精准的文本条件引导(token latents) |
| 架构 | 基于 RoBERTa 文本编码器 + 音频编码器,支持零样本泛化 |
1.2.3. Woosh-Flow / Woosh-DFlow:文本 → 音频生成
| 模型 | 类型 | 特点 |
|---|---|---|
| Woosh-Flow | 原始潜在扩散模型(LDM) | 支持无条件/文本条件生成,生成质量高 |
| Woosh-DFlow | 蒸馏加速版 | 推理速度提升 3-5×,6 步采样即可输出,适合实时交互 |
✅ 典型生成内容:
引擎轰鸣 雨声雷鸣 门轴吱呀 人群欢呼 激光音效 等影视/游戏常用音效。
1.2.4. Woosh-VFlow / Woosh-DVFlow:视频 → 音频生成
| 模型 | 输入 | 输出 | 核心能力 |
|---|---|---|---|
| Woosh-VFlow | 8 秒视频 + 可选文本 | 同步音频 | 基于视频帧特征 + 文本双重条件,生成时空对齐的音效 |
| Woosh-DVFlow | 同上(蒸馏版) | 同上 | 推理加速,保持音画同步精度 |
🎬 应用场景示例:
- 为无声视频自动添加环境音、动作音效(如脚步声、风声、掌声)。
- 支持仅视频条件(OV 模式)或视频+文本联合条件。
1.3. 技术亮点
- 专注音效领域:不同于通用音乐/语音生成模型,Woosh 针对短时长、高动态、强瞬态的音效数据专门优化,对冲击声、机械声、自然声等类别表现突出。
- 蒸馏加速推理:通过知识蒸馏技术,将原始扩散模型步数从 50+ 压缩至 6 步,在几乎不损失质量的前提下实现秒级生成,适合交互式应用。
- 模块化设计:各组件(AE/CLAP/Flow/VFlow)可独立使用或灵活组合,便于研究者进行迁移学习、模块替换或轻量化部署。
- 多基准评估验证:在公开数据集(如 AudioSet、Freesound)及索尼内部测试集上,多项指标(CLAP Score、FAD、MOS)达到或超越 Stable Audio Open、TangoFlux、MM-Audio 等开源方案。
1.4. 应用场景
| 领域 | 应用示例 |
|---|---|
| 🎬 影视后期 | 自动 Foley 音效生成、环境声补全、无声素材配音 |
| 🎮 游戏开发 | 动态音效系统、程序化音频内容生成、NPC 行为配音 |
| 📱 交互设计 | UI 音效定制、无障碍反馈音生成、AR/VR 空间音频 |
| 🔬 学术研究 | 多模态生成基座、音频表征学习、扩散模型改进实验 |
| 🎨 创意工具 | AI 辅助音效设计、提示词驱动的声音探索、视频配乐原型 |
1.5. 开源协议
| 组件 | 许可证 |
|---|---|
| 主体代码 | MIT License |
| VFlow 相关代码 | Apache 2.0(含 MM-Audio 适配部分) |
| 公开模型权重 | CC-BY-NC(知识共享·署名·非商业性使用) |
| 测试样本媒体 | 各文件附带独立授权说明 |
⚠️ 注意:模型权重不可用于商业目的,但研究、教育、个人创作均可自由使用。
1.6. 项目元信息
- 发布机构:Sony AI + Sony Group Corporation
- 团队:Gaëtan Hadjeres, Marc Ferras, Khaled Koutini 等 10 位研究者
- 代码语言:Python (100%)
- 依赖框架:PyTorch, Transformers, Gradio, Hugging Face Hub
- 硬件支持:CPU / CUDA / MPS (Apple Silicon)
- GitHub:SonyResearch/Woosh
- Star 数:190+(持续上升中)
💡 一句话总结:
Woosh 是目前最专注音效生成的开源基础模型套件,以高质量、模块化、可蒸馏为核心优势,为创意工作者和研究人员提供了强大的音频生成新工具。
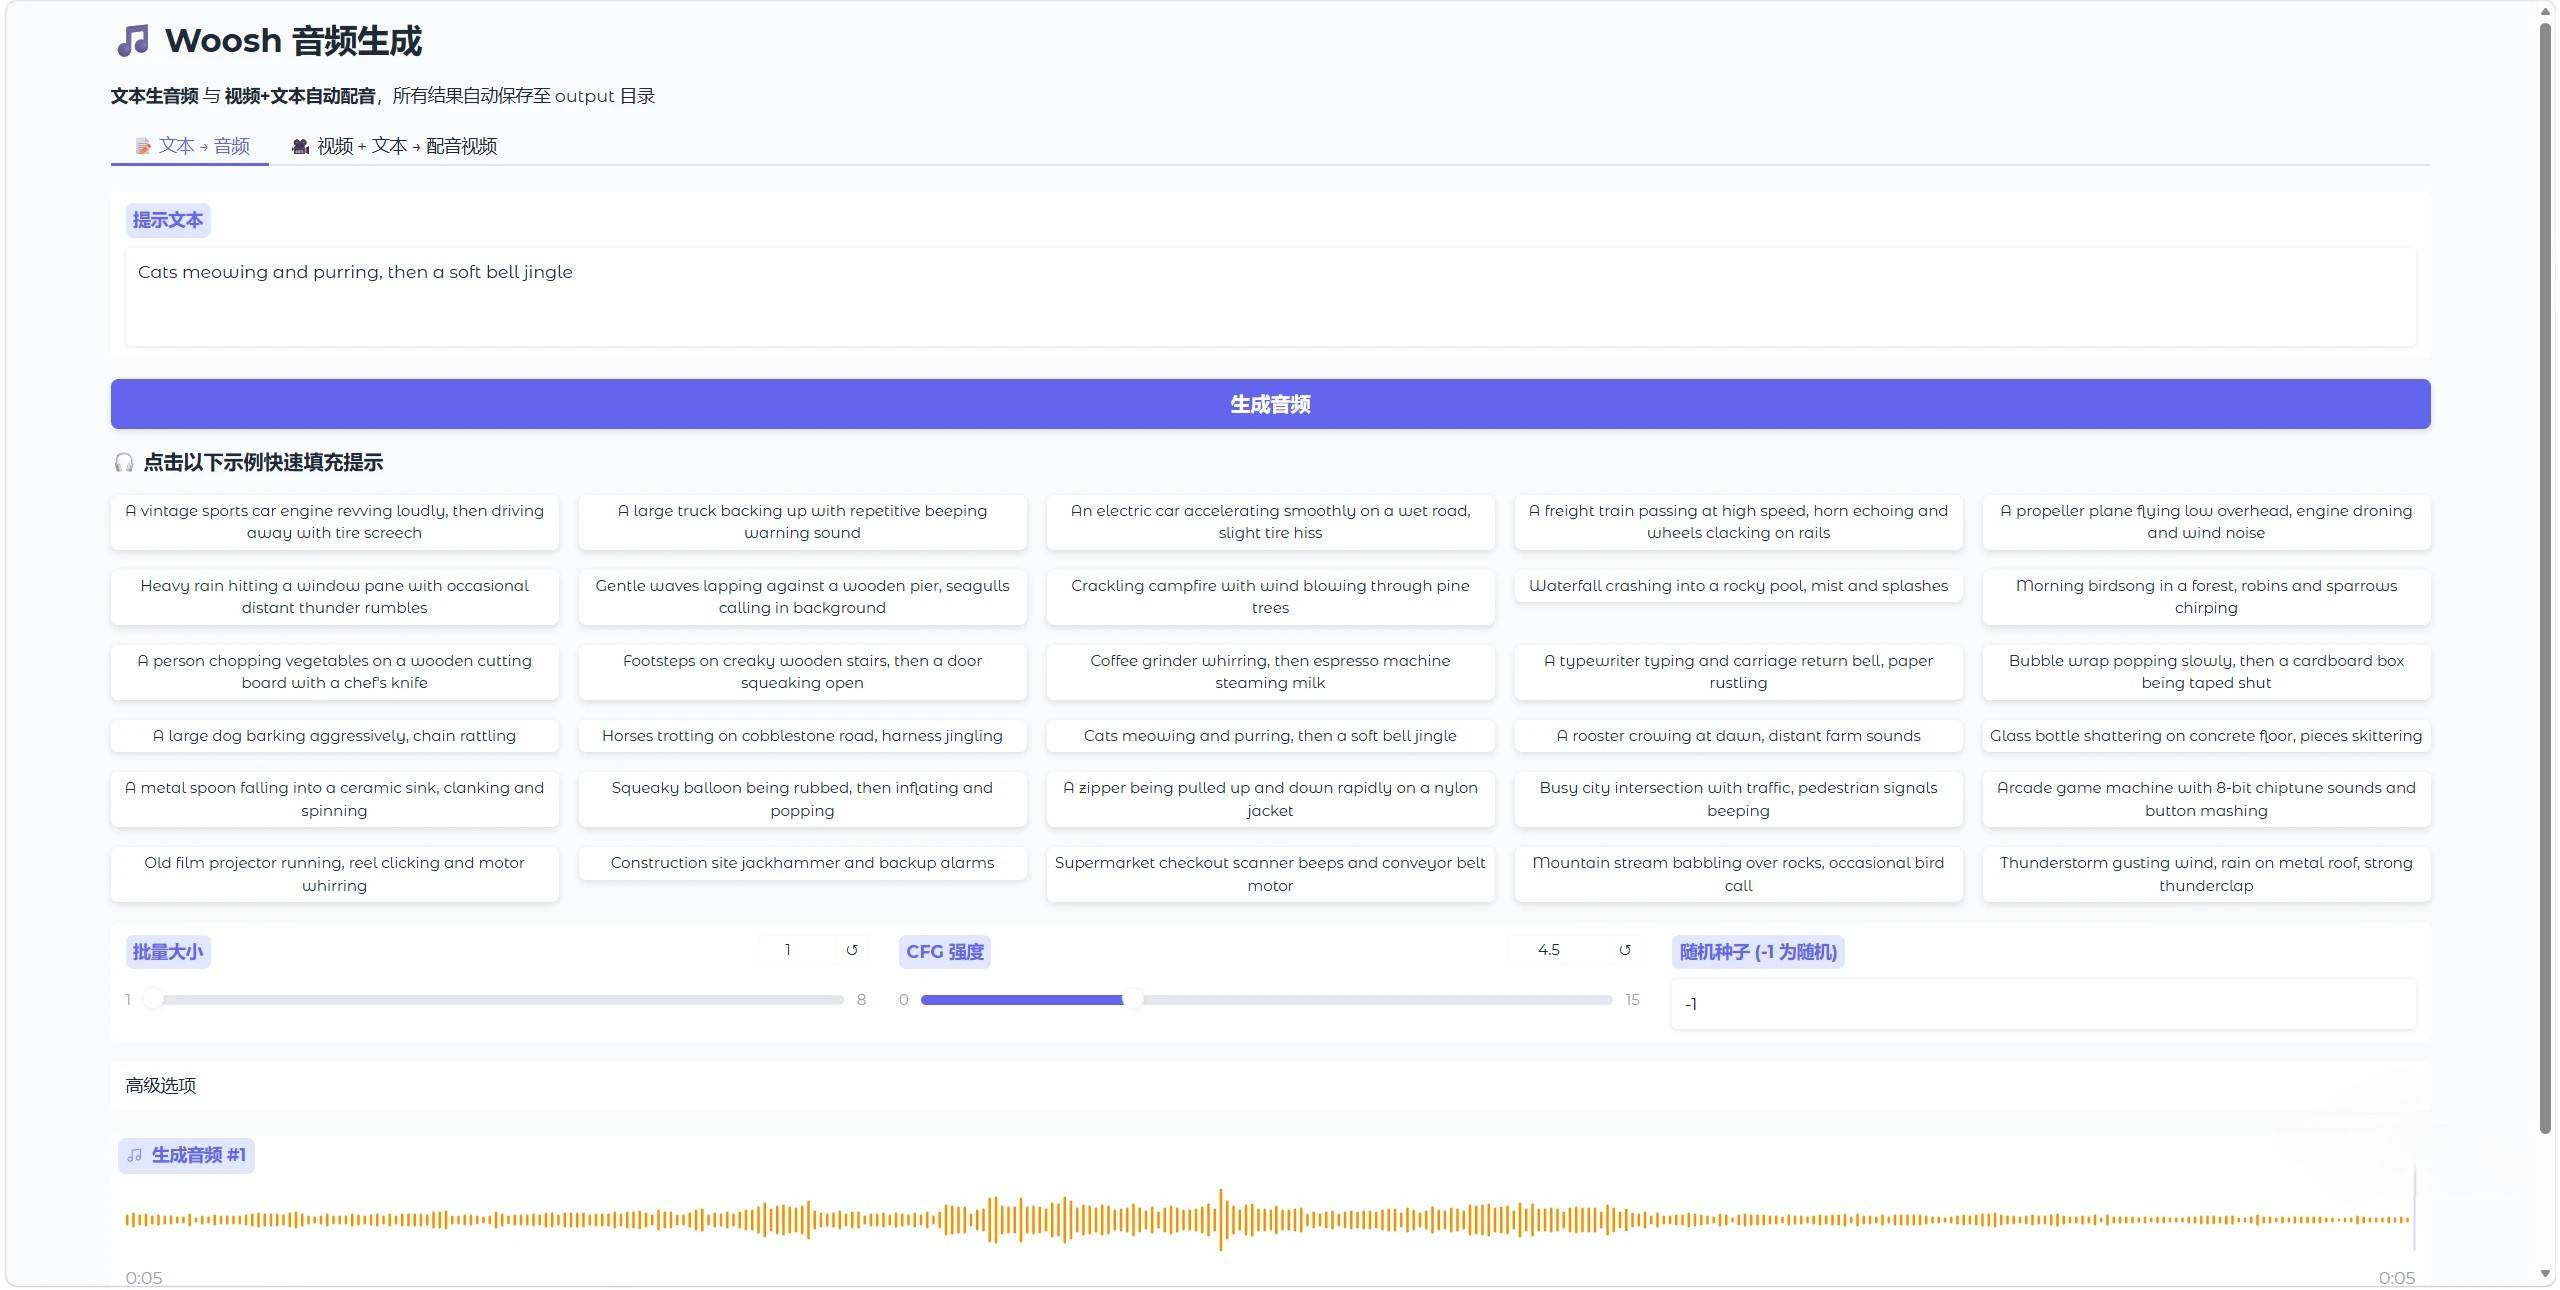
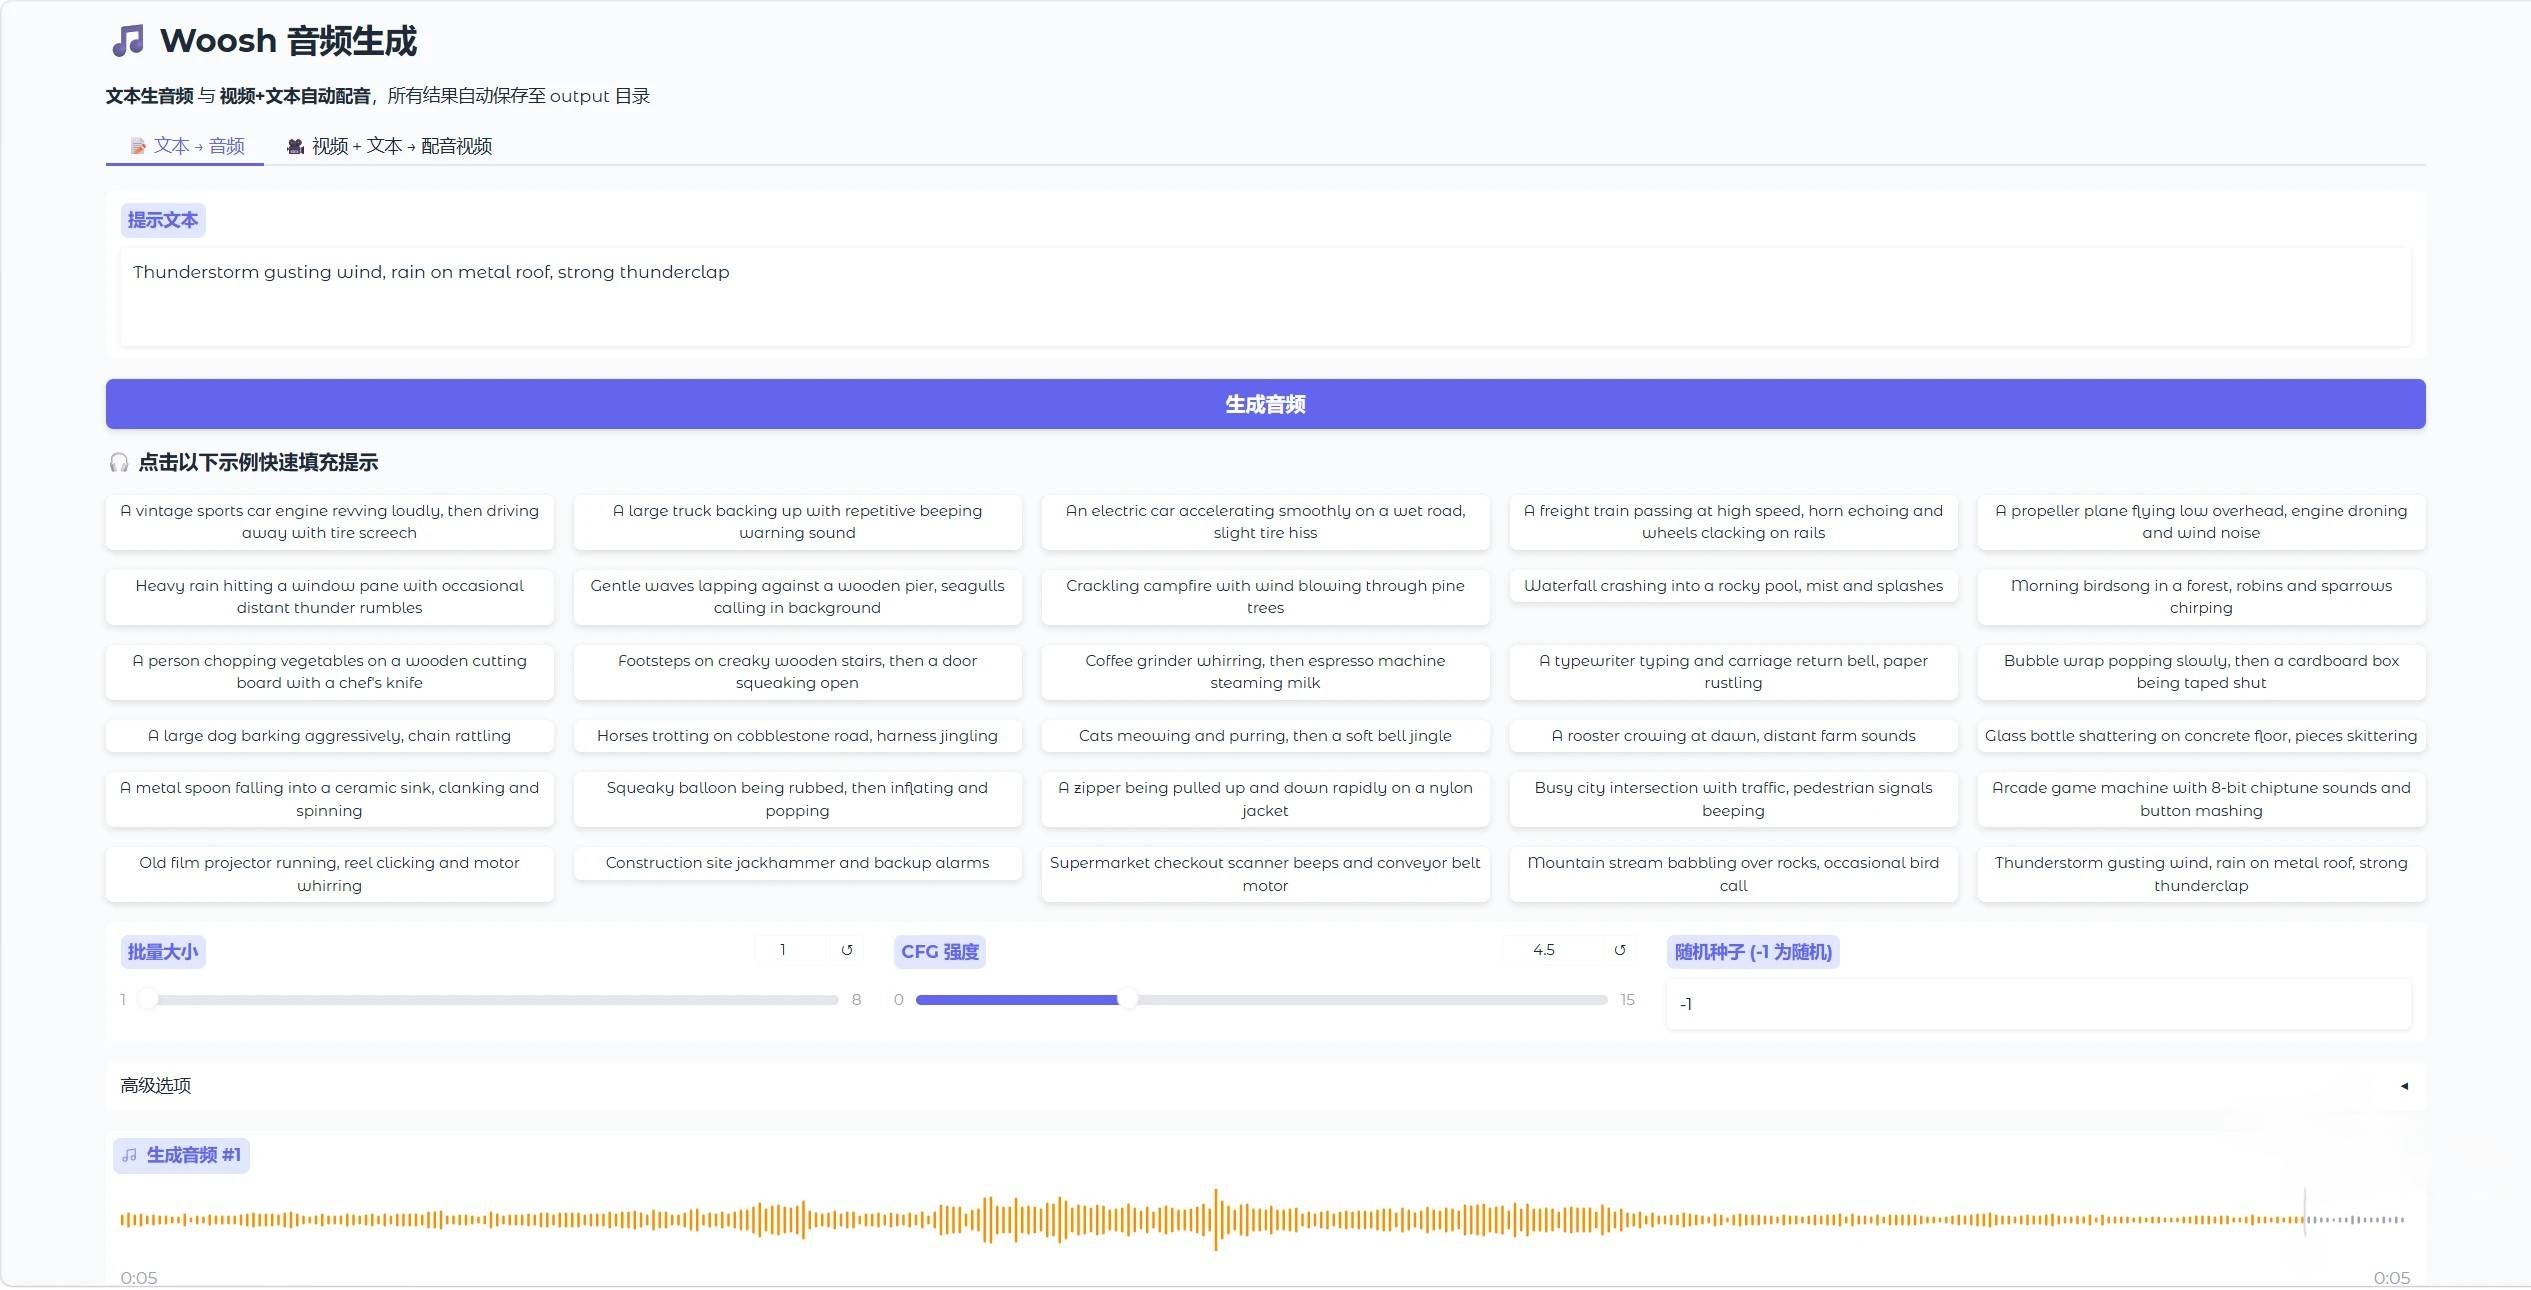
1.7. 整合包说明
- 硬件要求:英伟达 8G 显卡即可流畅运行。
- 性能表现:生成音效速度极快。
- 后续计划:根据社区人气持续开发更新。
1.8. 下载地址
- 夸克网盘:点击下载
- 帮助文档:下载及使用常见问题解答