Seedance 2.0 完整操作手册:AI视频创作进入"人人都是导演"时代
[!info] 阅读导览
全文 8 节:多模态自由组合(1.1)→ 能力速览(1.2)→ 操作方式详解(1.3,五步走)→ 核心能力详解(1.4,十一大能力)→ 提示词写作技巧(1.5,含五个实战模板)→ 避坑指南(1.6)→ 写在最后(1.7)→ 彩蛋(1.8)
flowchart LR
    A[四种模态输入<br>图片×9 · 视频×3 · 音频×3 · 文字] --> B["@ 引用分配任务"]
    B --> C[Seedance 2.0 多模态融合]
    C --> D[4-15 秒视频<br>自带音效配乐]
1. Seedance 2.0 完整操作手册:AI 视频创作进入"人人都是导演"时代
这两天,字节的 AI 视频模型 Seedance 2.0 彻底出圈了。
到处都是 Seedance 2.0 生成的 AI 作品。
有人用它做出了电影级的追逐戏,有人用它复刻了广告大片的运镜,还有人拿它做古装穿越剧和各种武打动作片,画面精致到让人分不清是 AI 生成的还是真人拍的。
不夸张地说,Seedance 2.0 这波更新,直接把 AI 视频生成的门槛踩到了地板上。
多说无用,先上个混剪 ↓
效果如何?
为什么这么火?因为它解决了一个所有创作者都头疼的问题:以前 AI 视频只能"生成",现在终于能"控制"了。
1.1. 用图片、视频、音频、文字自由组合,人人都能当导演

我们都知道,以前做 AI 视频,你只能打字描述想要什么画面,或者最多放一张图当起始帧。说实话,这种方式表达能力太有限了——你脑子里想的是电影级别的镜头感,打出来的却只是干巴巴的一段话。
现在不一样了。
它不再只是一个"文生视频"工具了,而是变成了一个真正能听懂你想法的多模态视频创作平台。 你可以同时丢给它图片、视频、音频、文字,告诉它每个素材分别干嘛用,然后它帮你把这些东西揉在一起,生成一段完整的视频。
听起来有点抽象?没关系,下面我把所有功能和玩法拆开了讲。
1.2. 先搞清楚:Seedance 2.0 到底能干嘛?
最核心的变化就一个词:多模态。
以前的视频生成工具,输入基本就两种:文字描述,或者一张首帧图。你想控制镜头怎么动、角色做什么表情、背景音乐什么节奏,基本只能靠提示词硬写,写得好不好全凭经验。
Seedance 2.0 直接把输入扩展到了四种模态:
- 图片:最多上传 9 张,可以指定角色长相、场景风格、服装细节、商品外观,甚至分镜脚本图都行。
- 视频:最多上传 3 个(总时长不超过 15 秒),可以让模型参考里面的运镜方式、动作节奏、转场特效,相当于给模型一个"样片"。
- 音频:支持 MP3 上传,最多 3 个(总时长不超过 15 秒),可以指定背景音乐、音效风格、甚至参考某个视频里的旁白音色。
- 文字:自然语言描述,写清楚你想要什么画面、什么动作、什么节奏就行。
这四种输入可以自由组合,混合上传的文件总上限是 12 个。生成的视频时长最长 15 秒,可以自由选择 4 到 15 秒,而且自带音效和配乐。
简单来说,你终于可以像一个真正的导演一样去"指挥" AI 了:用图片定风格,用视频定动作,用音频定节奏,用文字定剧情。
1.2.1. 核心参数一览
先看看 Seedance 2.0 能接受什么输入、能输出什么:
| 参数 | 说明 |
|---|---|
| 图片输入 | 最多 9 张 |
| 视频输入 | 最多 3 个,总时长不超过 15 秒 |
| 音频输入 | 支持 MP3,最多 3 个,总时长不超过 15 秒 |
| 文字输入 | 自然语言描述(中英文都行) |
| 生成时长 | 4-15 秒,自由选择 |
| 声音输出 | 自带音效和配乐 |
| 文件总上限 | 所有素材加起来最多 12 个文件 |
小建议:素材不是越多越好。优先上传对画面或节奏影响最大的素材,合理分配数量。

1.3. 怎么用?操作方式详解
1.3.1. 第一步:选对入口
打开即梦,找到 Seedance 2.0,你会看到两个入口:
- 首尾帧入口:只上传首帧图 + 文字描述时用这个
- 全能参考入口:需要多模态组合(图片 + 视频 + 音频 + 文字)时用这个
怎么选?记住一个原则:素材只有一张图加文字,走首尾帧;素材超过一张图,或者有视频、音频参与,走全能参考。
大部分情况下选择全能参考即可,它支持各种参考输入,也就是最新的 Seedance 2.0 能发挥最大能力的方式。

1.3.2. 第二步:上传你的素材
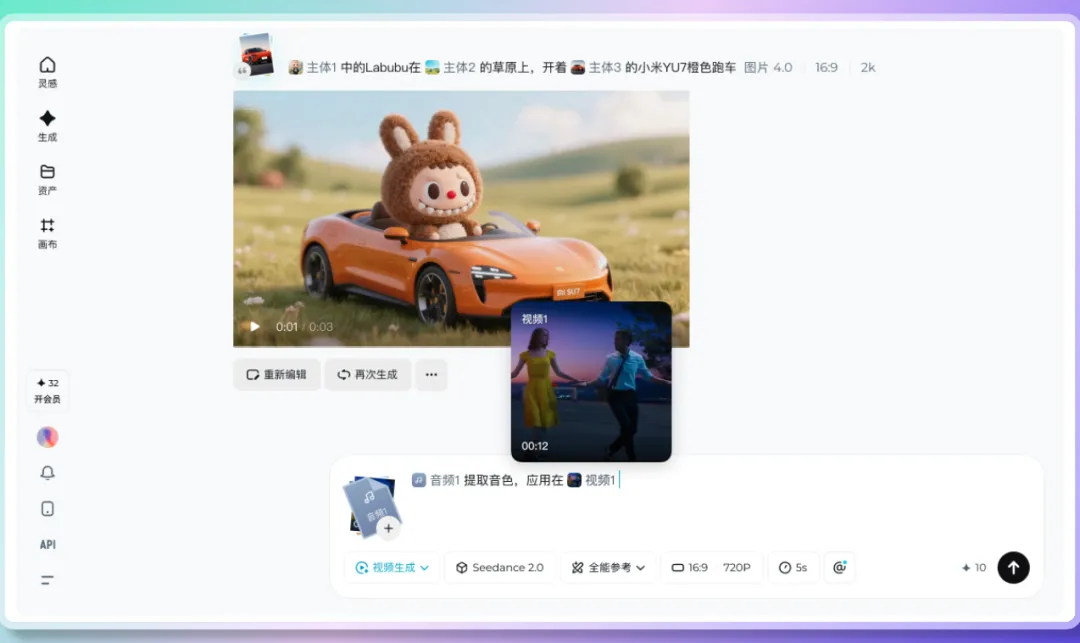
点击上传按钮,从本地选文件。图片、视频、音频都可以直接拖进去。上传成功后,所有素材会出现在输入框区域,鼠标悬停可以预览内容。
小建议:上传前想好哪些素材最关键。总共只能传 12 个文件,优先上传对画面风格和节奏影响最大的素材。

1.3.3. 第三步:用"@"给每个素材分配任务(最关键)
这一步是 Seedance 2.0 最核心的操作,也是很多新手容易忽略的地方。
上传完素材后,你需要在提示词里通过 @素材名 来告诉模型,每个素材具体干什么用。模型不会自己猜,你不说清楚,它就可能乱用。
比如:
@图片1作为首帧@视频1参考镜头语言@音频1用于配乐
1.3.3.1. 怎么唤起 @
方法一:在输入框里直接打一个"@"字符,会自动弹出已上传素材的列表,点击你要引用的素材,它就落入输入框了。

方法二:点击输入框旁边参数工具栏的"@"按钮,同样会弹出素材列表。

1.3.3.2. @ 的正确写法示例
指定首帧和参考:
@图片1作为首帧,参考@视频1的镜头语言,@音频1用于配乐指定角色形象:
@图片1的女生作为主角,@图片2的男生作为配角指定运镜参考:
完全参考@视频1的所有运镜效果和转场指定场景参考:
左边场景参考@图片3,右边场景参考@图片4指定动作参考:
@图片1的人物参考@视频1中的舞蹈动作指定音色参考:
旁白的音色参考@视频1
踩坑提醒:素材多的时候,一定反复检查每个 @ 引用有没有对上号。把图片当成视频引用,或者把角色 A 的图标成角色 B,模型生成出来就会很混乱。
鼠标放在你 @ 的素材上,悬停可以预览素材,避免插入错误。
1.3.4. 第四步:写好你的提示词
@ 分配完任务后,剩下的就是用自然语言描述你想要的画面和动作。
1.3.4.1. 写提示词的四个技巧
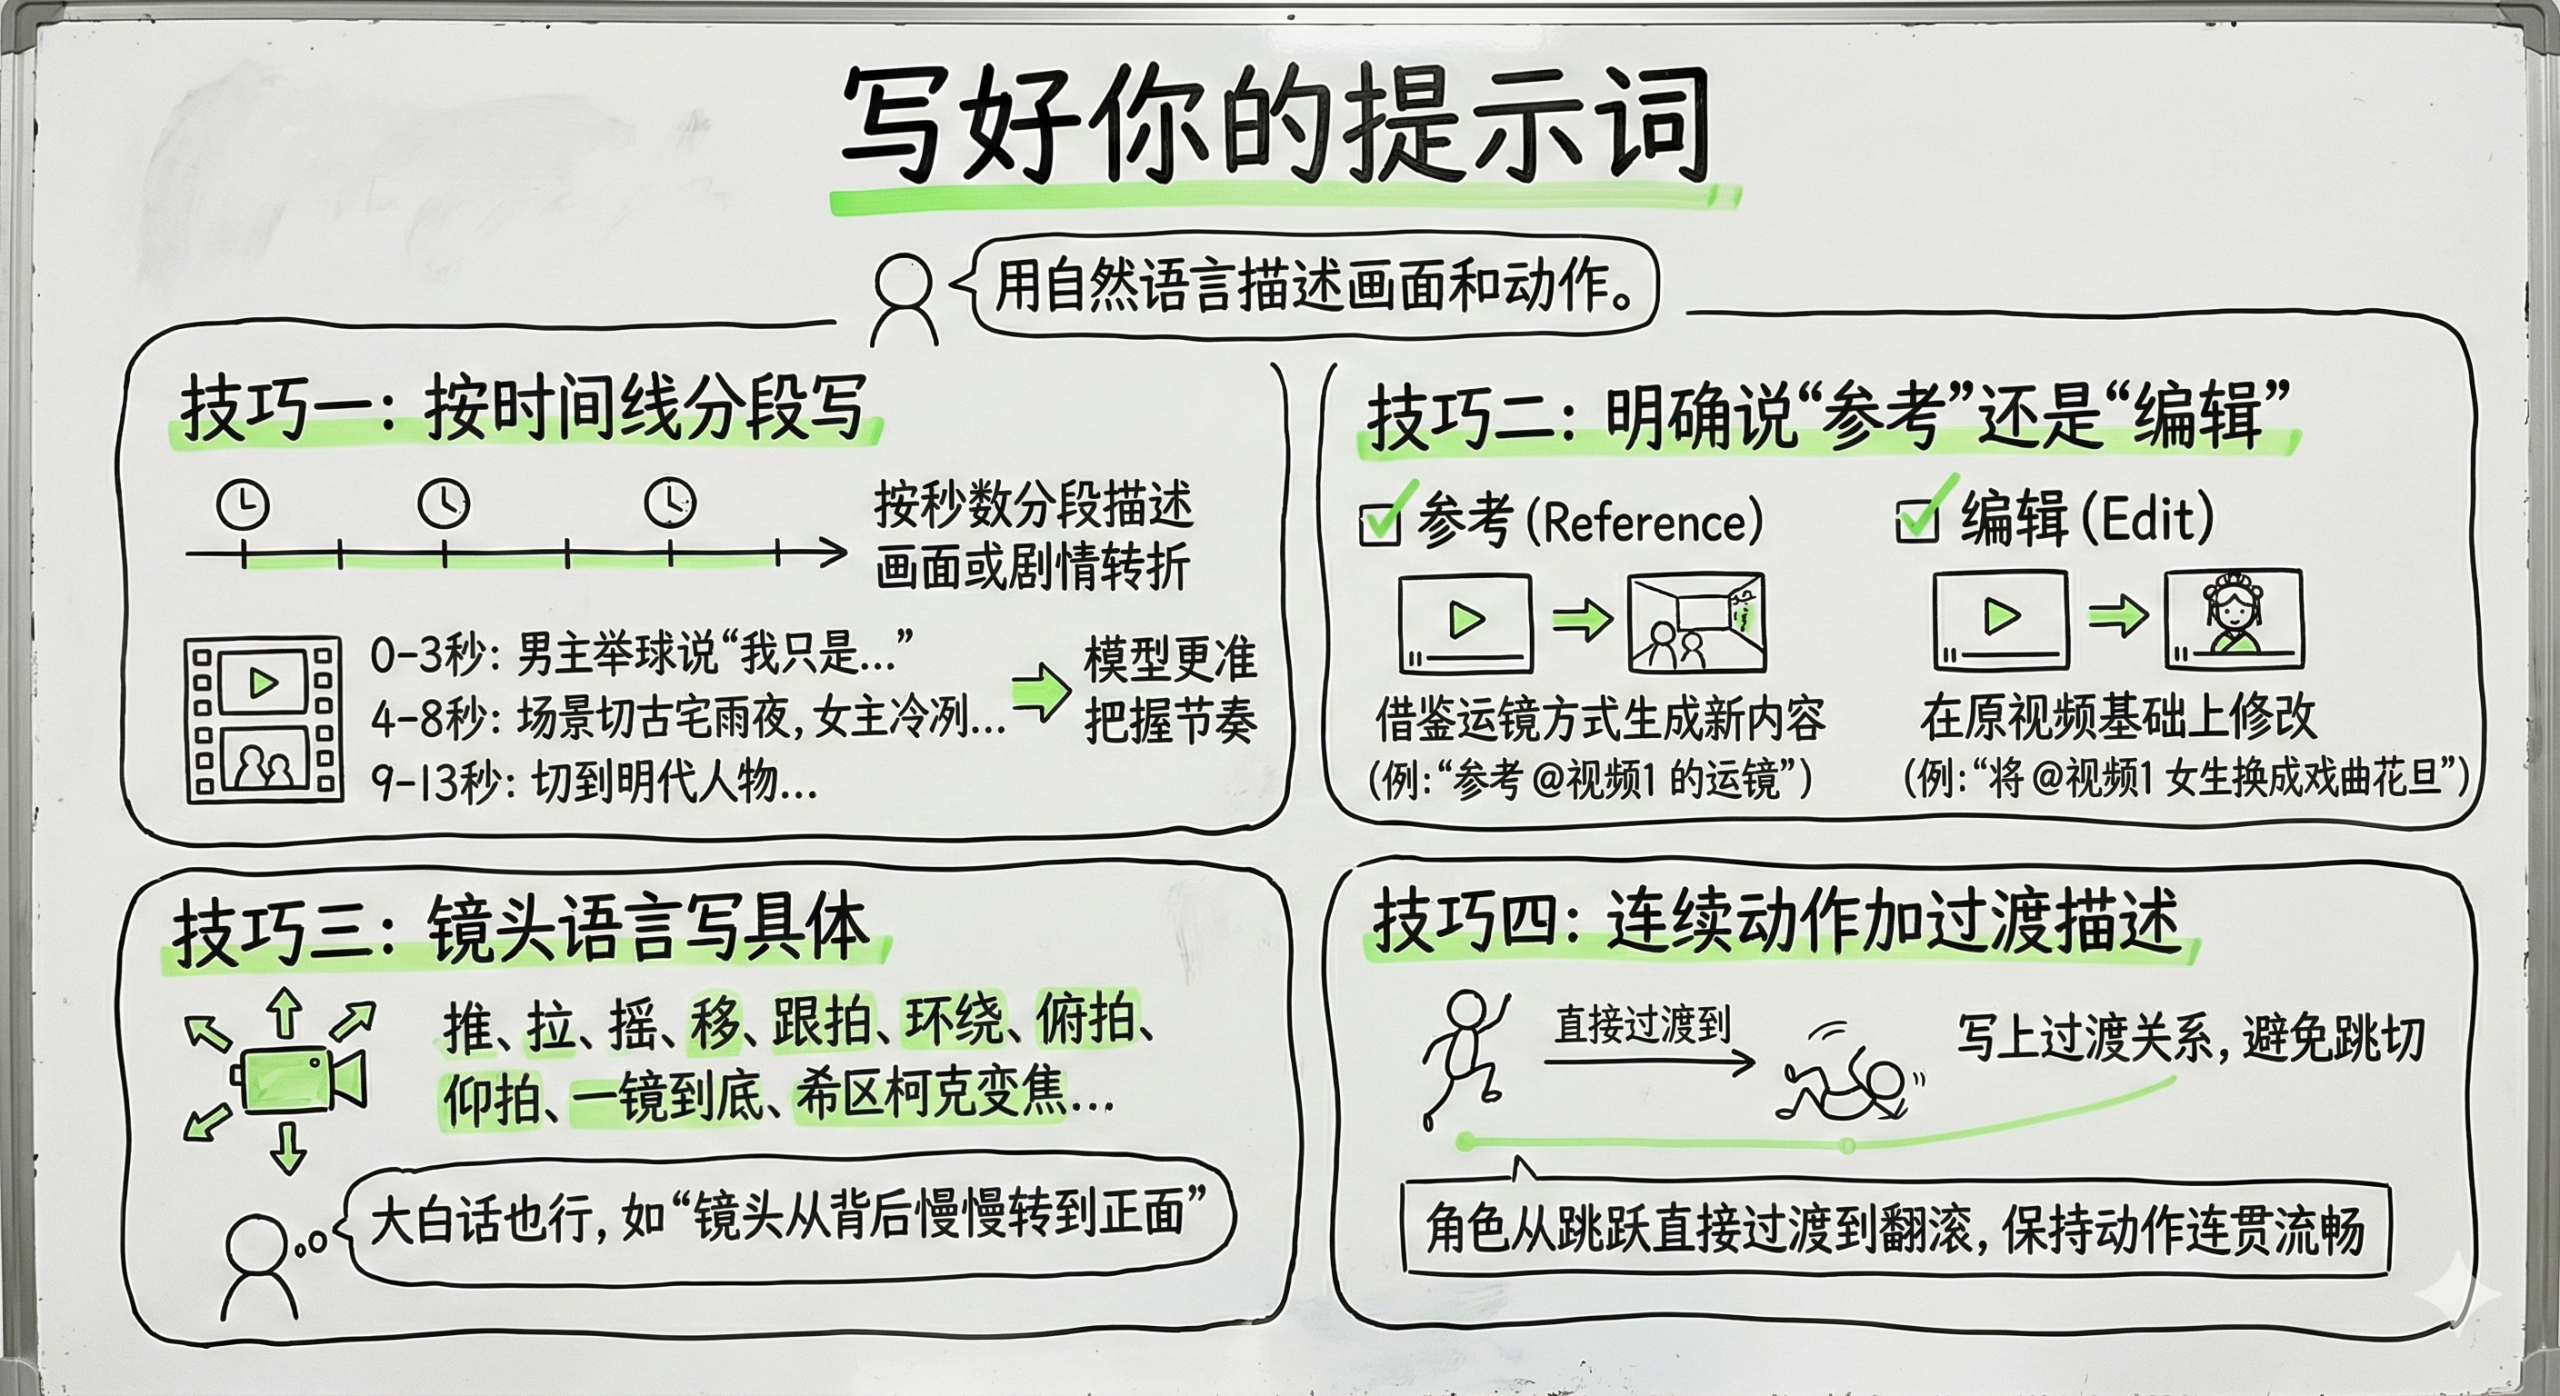
技巧一:按时间线分段写。 如果视频里有多个画面或剧情转折,建议按秒数分段描述。
比如:
0-3秒画面:男主手里举起一个篮球,抬头望向镜头,说"我只是想喝杯酒,该不会要穿越了吧……"
4-8秒画面:镜头突然剧烈晃动,场景切换成古宅的雨夜,一个穿着古装的女主冷冽地望向镜头方向。
9-13秒画面:镜头切到一个穿着明代服饰的人物……
这样写模型能更准确地把握每段画面的节奏和内容。
技巧二:明确说"参考"还是"编辑"。 这两个概念不一样。"参考 @视频1 的运镜"意思是借鉴它的镜头运动方式来生成新内容;"将 @视频1 中的女生换成戏曲花旦"意思是在原视频基础上做修改。写清楚,模型才能正确响应。
技巧三:镜头语言写具体。 不用怕写多,模型现在的理解能力很强。推、拉、摇、移、跟拍、环绕、俯拍、仰拍、一镜到底、希区柯克变焦、鱼眼镜头……这些专业术语它都认识。不懂术语也没关系,用大白话描述也行,比如"镜头从背后慢慢转到正面"。
技巧四:连续动作加过渡描述。 如果你想让角色做一系列连贯动作,记得写上过渡关系,比如"角色从跳跃直接过渡到翻滚,保持动作连贯流畅",避免画面出现不自然的跳切。
1.3.5. 第五步:选择生成时长,点击生成
在 4 到 15 秒之间选一个你需要的时长。
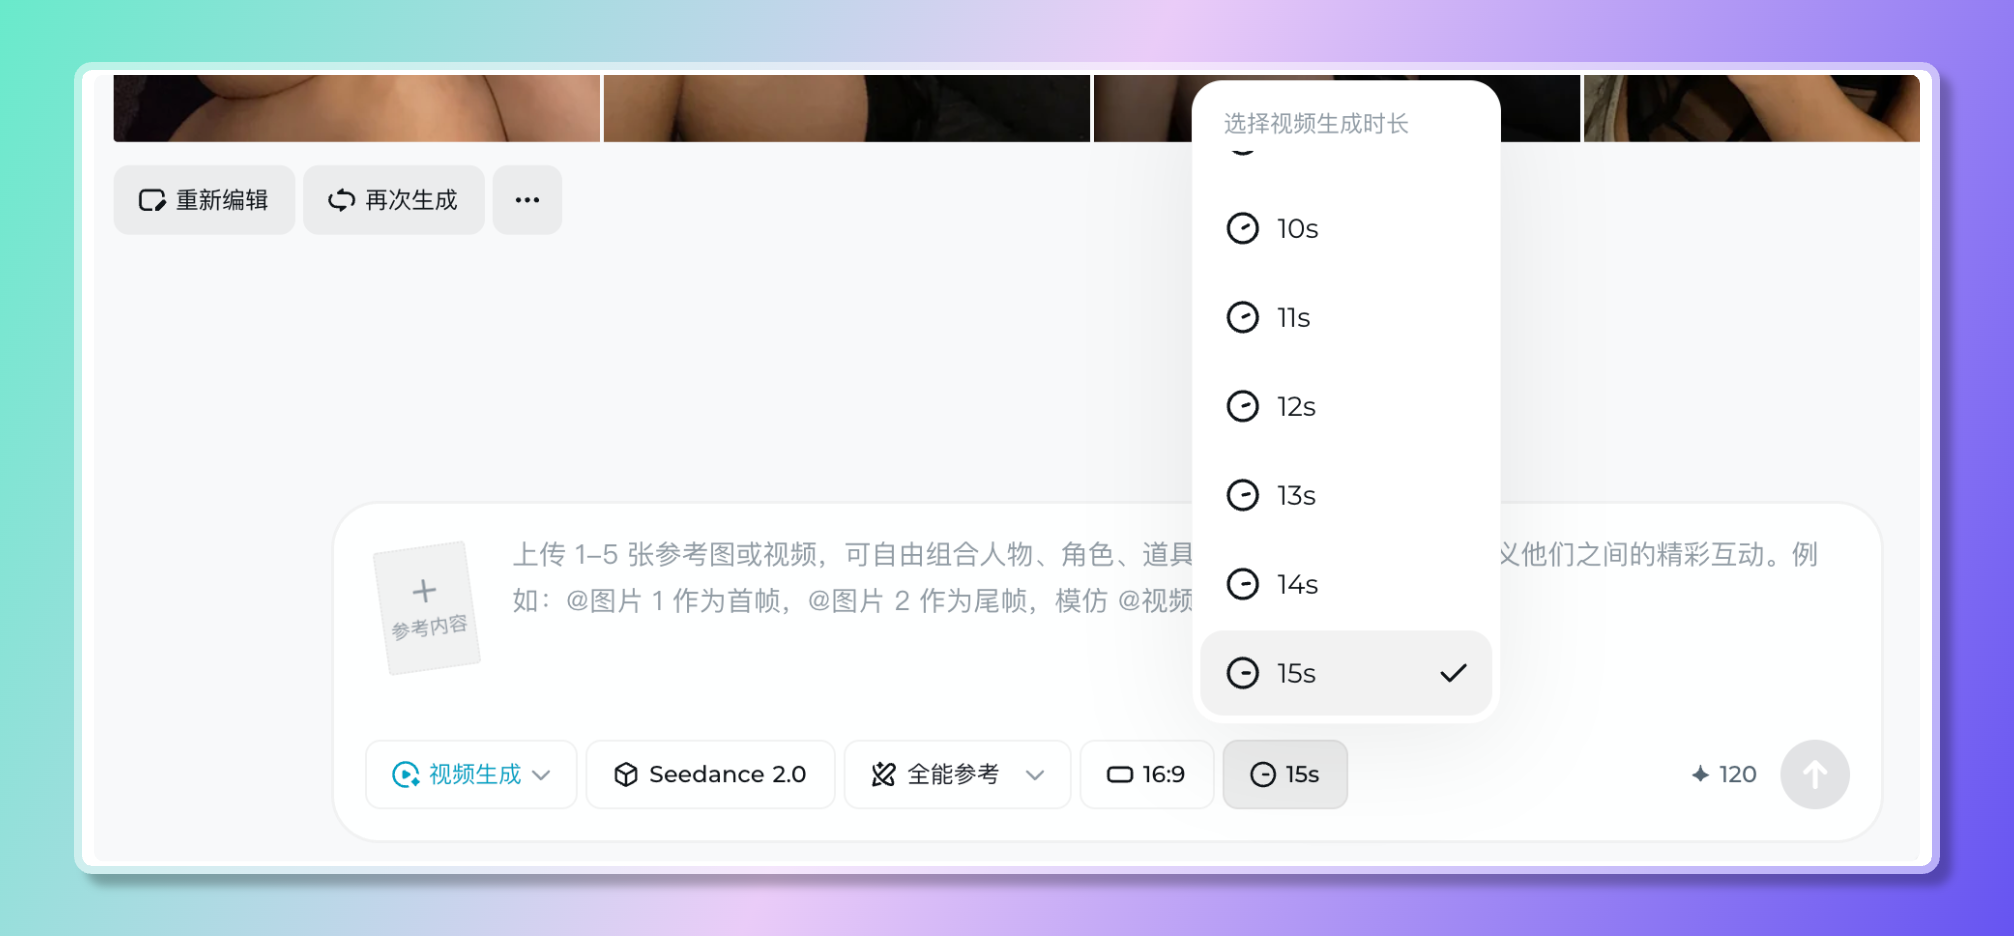
注意:如果你是在做视频延长(比如把一段已有视频往后接 5 秒),那这里选的时长是"新增部分"的时长,不是总时长。想延长 5 秒就选 5 秒。
然后点生成,等结果就好。不满意可以多生成几次,AI 本身有随机性,同样的输入每次结果都会有差异,挑最满意的那条。
1.4. Seedance 2.0 核心能力详解
下面是 Seedance 2.0 最强的十一个能力,每个都配有使用方法和实际案例。
1.4.1. 能力一:基础画面质量大幅提升
先说最基本的。Seedance 2.0 在底层做了全面升级,物理规律更合理,动作更流畅,风格更稳定。
Seedance 2.0 在最底层的画面生成能力上就有了质的飞跃:
- 物理规律更合理:衣服飘动、水花溅射、物体碰撞都更真实
- 动作更自然流畅:人物走路、跑步、做复杂动作不再僵硬
- 指令理解更精准:你说"女孩优雅地晒衣服",它真的能理解"优雅"是什么意思
- 风格保持更稳定:画面从头到尾一致,不会突然变风格

用法示例:
女孩在优雅的晒衣服,晒完接着在桶里拿出另一件,用力抖一抖衣服。
什么概念呢?“女孩在优雅地晒衣服,晒完接着在桶里拿出另一件,用力抖一抖衣服”,生成出来的画面里,衣服的飘动、手臂的发力、布料的质感,都非常接近真实拍摄的效果。
更复杂的场景也不在话下:
镜头跟随黑衣男子快速逃亡,后面一群人在追,镜头转为侧面跟拍,人物惊慌撞倒路边的水果摊爬起来继续逃
这种带追逐、碰撞、镜头切换的复杂场景,2.0 都能稳定生成。
还有更夸张的,有人用一段提示词让画中人物偷偷伸手拿可乐喝,听到脚步声赶紧放回去,最后镜头推进到纯黑背景只有一罐可乐加艺术字幕。这种叙事复杂度,以前想都不敢想。
1.4.2. 能力二:多模态自由组合
这是 2.0 最核心的升级——你可以用任何素材作为"参考"。
公式:Seedance 2.0 = 多模态参考(可参考万物)+ 强创意生成 + 精准指令理解
你可以参考的东西包括:
- 动作、特效、形式
- 运镜方式、镜头语言
- 人物形象、场景风格
- 声音、音乐节奏

1.4.2.1. 实用技巧
| 你想做什么 | 怎么写提示词 |
|---|---|
| 有首帧图,还想参考视频动作 | @图1为首帧,参考@视频1的打斗动作 |
| 延长已有视频 | 将@视频1延长 5s(生成时长也选 5s) |
| 融合多个视频 | 在@视频1和@视频2之间加一个场景,内容为xxx |
| 用视频里的声音 | 不需要单独上传音频,直接参考视频即可 |
| 连续动作 | 角色从跳跃直接过渡到翻滚,保持动作连贯流畅 |
1.4.3. 能力三:一致性全面提升
做过 AI 视频的人都懂,一致性是最折磨人的问题。角色脸前后不一样,商品换了个角度细节就丢了,场景风格忽然跳变……
2.0 在这方面下了大功夫。上传角色参考图后,整段视频里人物的长相、服装、体态都能保持一致。商品展示也一样,多角度旋转展示一个包包,正面侧面材质细节都不会丢。
能保持一致的元素:
- 人脸特征(五官、肤色、表情风格)
- 服装细节(纹理、颜色、图案)
- 品牌元素(Logo、字体、配色)
- 场景风格(光影、氛围、色调)
用法示例:
男人@图片1 下班后疲惫地走在走廊,脚步变缓,最后停在家门口,深呼吸调整情绪,然后翻找出钥匙进入家里,他的小女儿和一只宠物狗欢快地跑过来迎接拥抱

这里通过 @图片1 指定人物形象,全程保持一致。
1.4.4. 能力四:运镜和动作精准复刻
这是 2.0 被刷屏最多的能力。 以前想让 AI 模仿电影运镜,要么写一堆专业术语碰运气,要么干脆做不到。
现在只需要两步:上传一段你喜欢的运镜参考视频,然后写"参考 @视频1 的运镜效果"。
模型能识别参考视频里的镜头运动方式(推拉摇移、环绕、跟拍、变焦、一镜到底等等),然后把同样的运镜逻辑应用到你的新内容上。

能复刻的运镜类型:
- 希区柯克变焦
- 环绕跟拍
- 一镜到底
- 推拉摇移
- 低角度仰拍
- 俯拍鸟瞰
示例:复刻经典武侠场面
作者:@蒙不太奇 他说这个视频以前需要 10 天时间,现在只需要 1 个小时,上传参考视频可以很快复制武打动作。
1.4.5. 能力五:创意模板和特效精准复刻
看到一个很酷的广告创意、转场特效、电影片段?直接上传作为参考,模型能识别其中的动作节奏、视觉结构和镜头语言,帮你复刻出属于自己的版本。
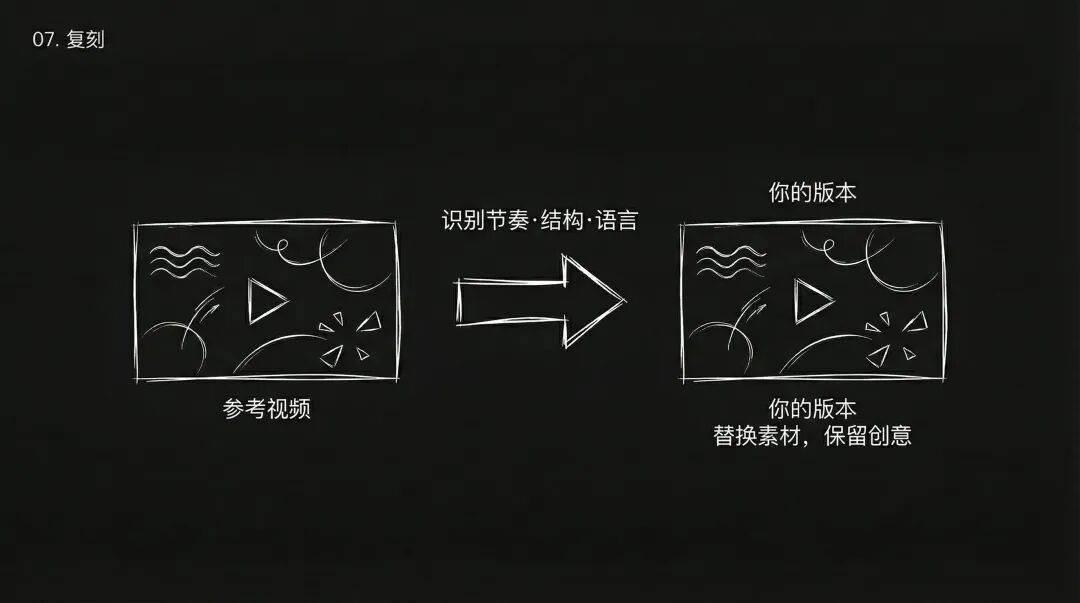
能复刻的创意类型:
- 创意转场(拼图破碎、粒子消散、瞳孔穿越等)
- 广告成片风格
- MV 节奏剪辑
- 电影特效镜头
- 变装/换脸效果
示例:
特效镜头拉满…
1.4.6. 能力六:视频延长和衔接
已经有一段满意的视频,想接着往后拍?或者想往前补一段前情?视频延长功能直接搞定。
向后延长:上传已有视频,写"将 @视频1 延长 X 秒"加上新画面的描述。
向前延长:写"向前延长 X 秒"加上前情内容描述。
使用规则:
- 告诉模型"将@视频1延长 X 秒"
- 生成时长要选成延长部分的时长(比如延长 5 秒,生成长度选 5 秒)
- 可以在延长部分加入新的剧情和画面描述
- 支持向前或向后延长
用法示例:

通过参考图和参考视频,将上面 2 秒钟的视频延长到 15 秒。
延长的内容可以很具体,包含镜头运动、画面元素、文字出现等。
1.4.7. 能力七:声音更真实
2.0 生成的视频自带音效和配乐,而且声音质量比之前好了很多。
几种声音相关的玩法:
参考音色:上传一段视频或音频,让模型模仿里面的说话音色或旁白风格。
多语言对话:角色可以说中文、英文、西班牙语、韩语等多种语言,而且情感表达比较到位。
多角色对话:支持一段视频里多个角色各说各的台词。比如猫狗脱口秀、古装戏对白、军事题材的战术对话,都有成功案例。
方言支持:有人成功让角色说四川话点奶茶,效果相当有味道。
音效匹配:走路声、雷鸣声、人群嘈杂声、装备碰撞声,这些环境音效都能比较准确地生成。
效果展示:(作者:虚妄)↓
师兄们喜欢吗?
1.4.8. 能力八:一镜到底更连贯
"一镜到底"需要长时间保持画面连贯,同时处理复杂的空间转换和镜头运动,对 AI 来说一直是硬骨头。
Seedance 2.0 在这方面明显进步了。上传多张不同场景的图片,写"一镜到底的追踪镜头,从街头跟随跑步者上楼梯、穿过走廊、进入屋顶,最终俯瞰城市",模型能完成场景之间的自然过渡,不会出现明显的断裂感。

更复杂的一镜到底也能做。比如"从第一人称视角出发,穿过舷窗看到云朵变成冰淇淋,镜头拉回机舱内,角色拿起冰淇淋吃了一口",这种涉及视角转换和虚实结合的一镜到底,Seedance 2.0 也能撑住。

还有谍战片风格的一镜到底:镜头跟拍红衣女特工在人群中穿行,经过拐角遇到面具女孩,继续追踪到豪宅消失,全程不切镜。这种叙事密度的一镜到底,能做到这个程度已经相当 impressive 了。

用法示例:
@图片1@图片2@图片3@图片4@图片5,一镜到底的追踪镜头,从街头跟随跑步者上楼梯、穿过走廊、进入屋顶,最终俯瞰城市。
技巧:多张图片按顺序排列,模型会按顺序在一镜到底中依次展现这些场景。
1.4.9. 能力九:视频编辑能力
已经有了一段视频,不想从头再做,只想改其中一部分?现在可以直接用已有视频作为输入,做定向修改。
角色替换:把视频里的 A 换成 B,动作和表情保持不变。比如"视频1中的女主唱换成图片1的男主唱,动作完全模仿原视频"。
剧情颠覆:保持场景和角色不变,但完全改写剧情走向。有人把一段深情的桥上赏月视频,改成了男主把女主推下水的反转剧情。还有人把一段紧张的酒吧谈判,改成了掏出一大包零食的搞笑反转。
元素修改:改发型、加道具、换背景。比如"将视频1女人发型变成红色长发,@图片1 中的大白鲨缓缓浮出半个脑袋在她身后"。
品牌植入:在已有视频里插入品牌元素。比如在炸鸡视频里加上印有品牌 Logo 的纸袋特写。
示例——替换角色:
复刻黑神话悟空,然后和美国队长对打
1.4.10. 能力十:音乐卡点
上传一段有节奏感的音乐视频作为参考,模型能识别音乐的节拍变化,让画面切换精准地踩在节拍上。
基础卡点:上传素材图片和音乐参考视频,写"根据 @视频 中的画面节奏进行卡点"。
动感卡点:写"画面中的人物更有动感,整体画面风格更梦幻,画面张力强,可根据音乐需求自行改变参考图的景别"。
风光卡点:多张风景图配音乐,写"风光场景图参考 @视频 中的画面节奏,转场间画面风格及音乐节奏进行卡点"。

用法示例:
@图片1@图片2@图片3@图片4@图片5@图片6@图片7 中的图片根据@视频中的画面关键帧的位置和整体节奏进行卡点,画面中的人物更有动感,整体画面风格更梦幻
关键写法:多张图 + 一个节奏参考视频 + “根据节奏进行卡点”。
1.4.11. 能力十一:情绪演绎更到位
角色表情僵硬、情绪转换生硬,一直是 AI 视频的老毛病。2.0 在这方面有明显改善。
你可以上传一段情绪参考视频,让模型模仿里面的表情变化。比如"@图片1 的女子走到镜子前,沉思了一会突然开始崩溃大叫,抓镜子的动作和崩溃大叫的情绪完全参考 @视频1"。
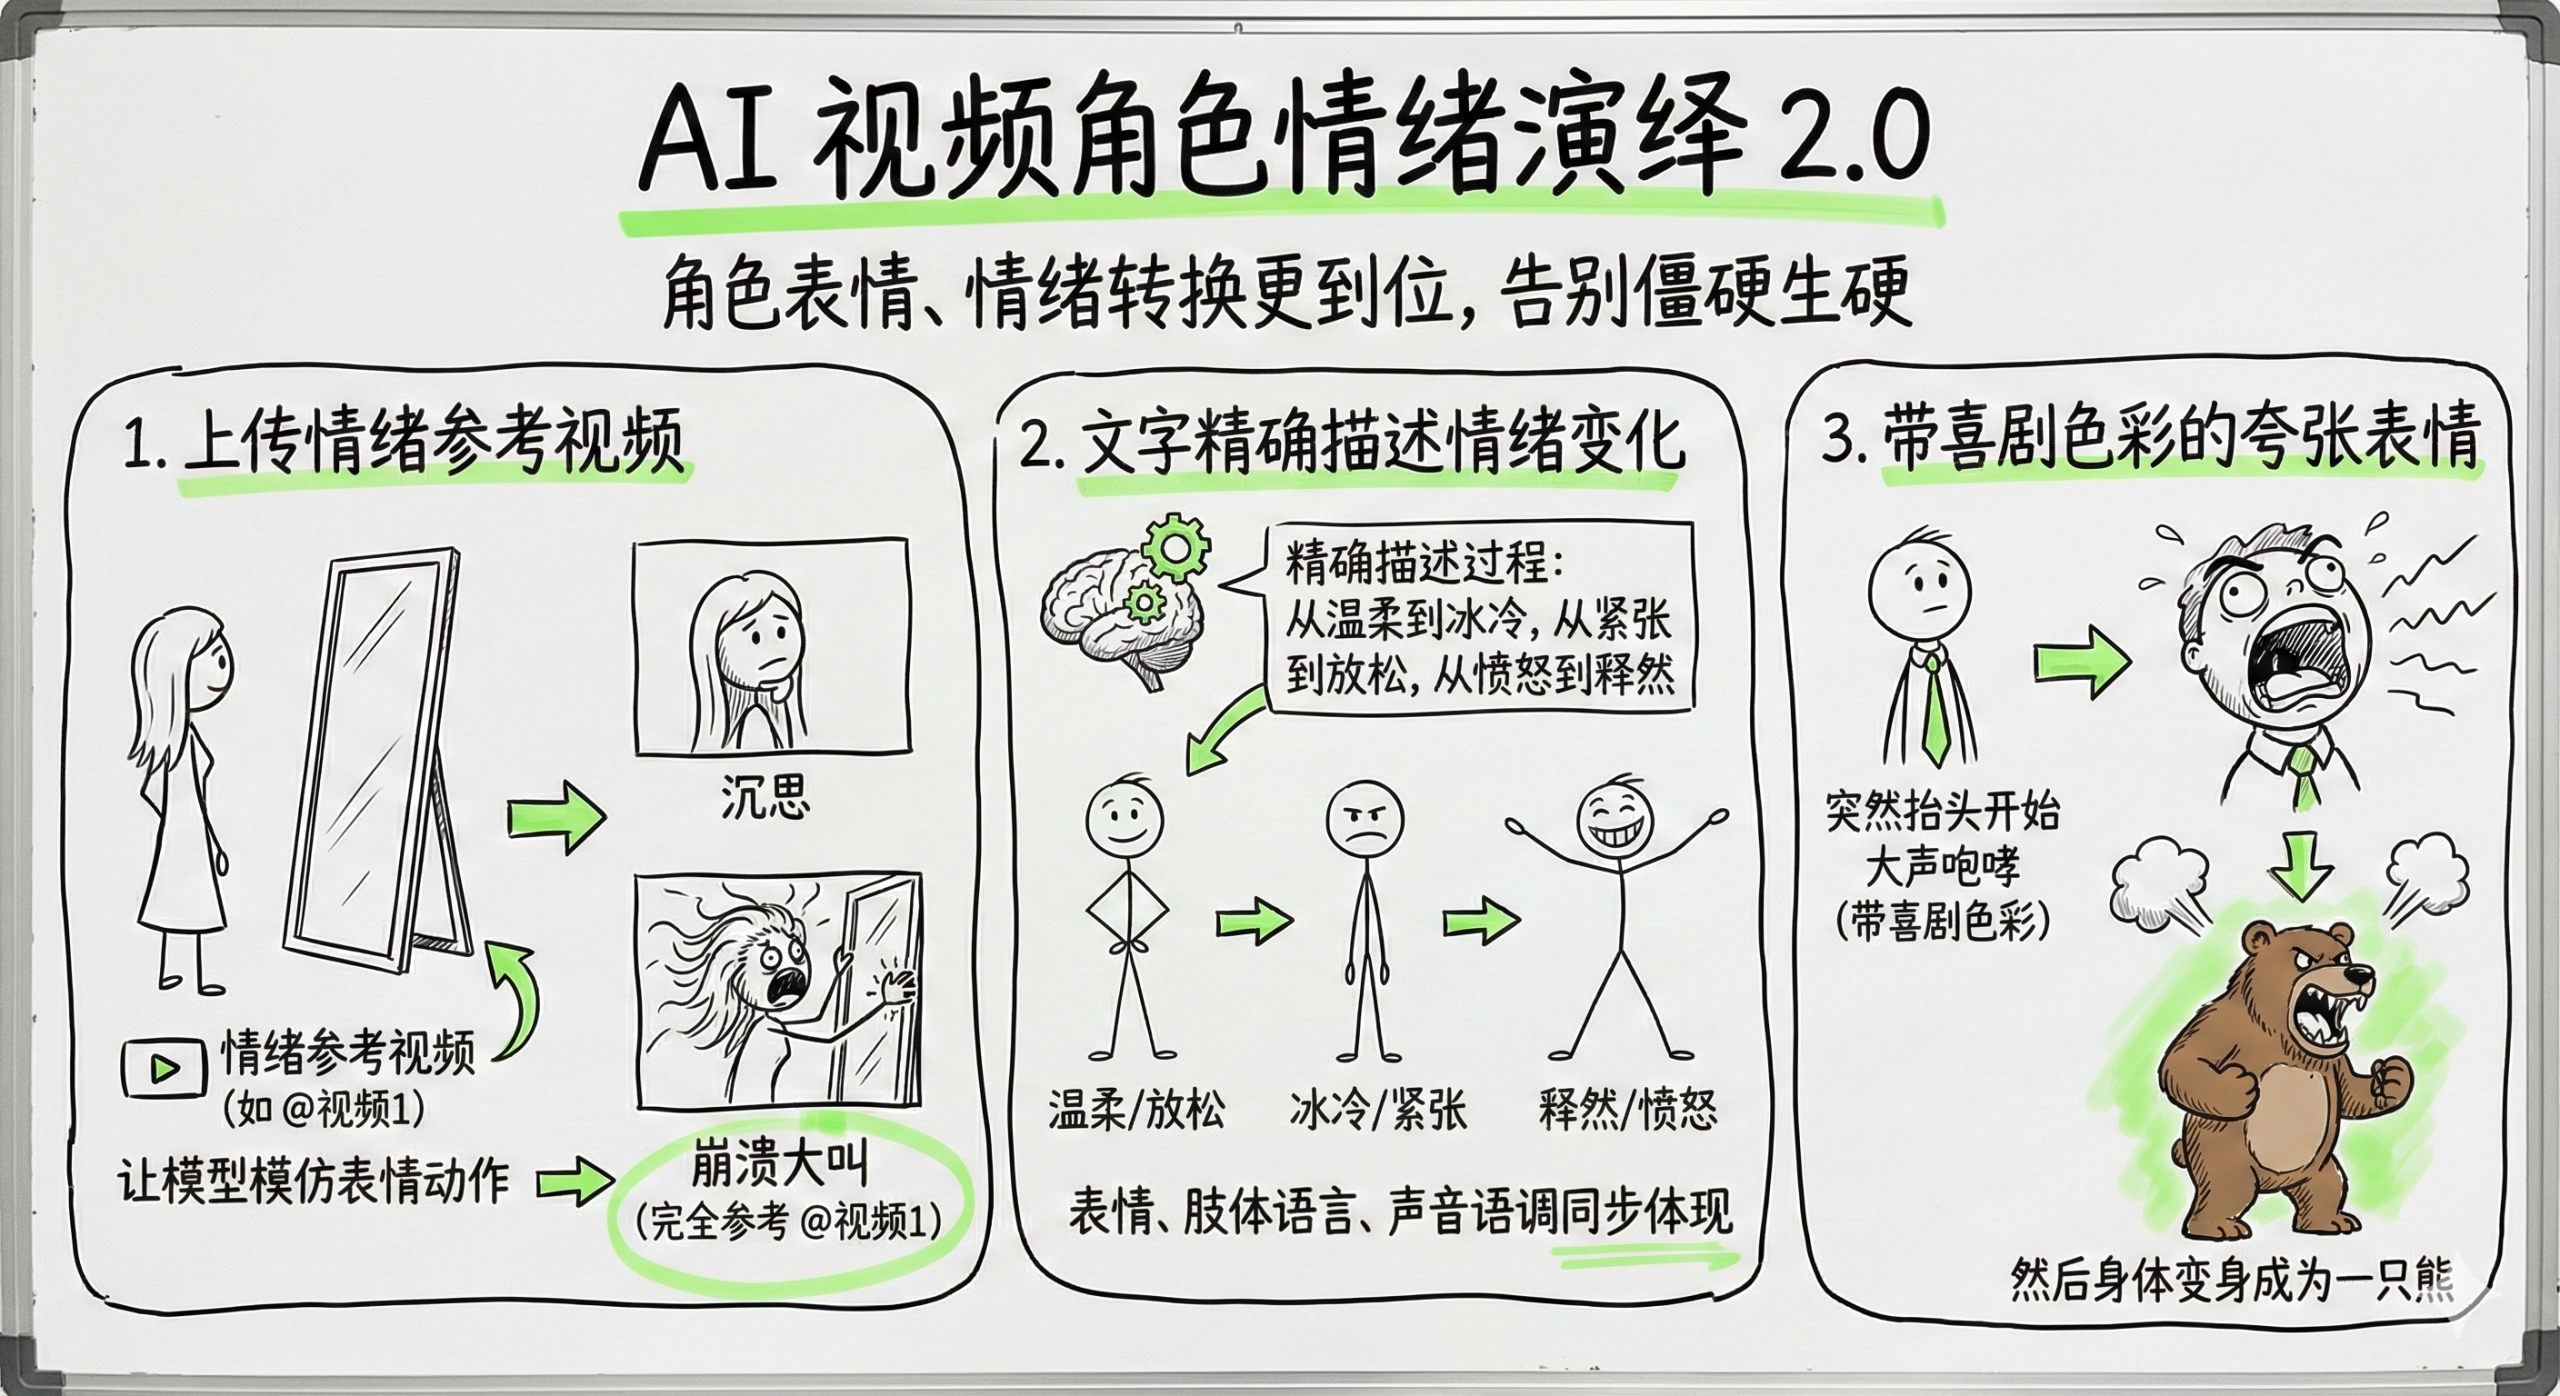
也可以用文字精确描述情绪变化过程:从温柔到冰冷,从紧张到放松,从愤怒到释然。模型能理解这些情绪转变,并且在角色的表情、肢体语言、声音语调上同步体现。
甚至可以做带喜剧色彩的夸张表情:比如"人物突然抬头开始大声咆哮"。

1.5. 提示词写作技巧总结
1.5.1. 写得好 vs 写得一般
| 一般写法 | 更好的写法 |
|---|---|
| “参考这个视频” | “参考@视频1的运镜方式和转场效果” |
| “用这张图” | “@图片1作为首帧,人物形象参考@图片2” |
| “做一段有节奏的视频” | “参考@视频1的画面节奏和音乐卡点” |
| “延长视频” | “将@视频1延长5秒,新增内容为xxx” |
| “换个人” | “将@视频1中的女主换成@图片1的形象,动作完全模仿原视频” |
1.5.2. 黄金公式
@素材 + 用途说明 + 具体画面描述 + 时间线(可选)
比如:
@图片1作为首帧,参考@视频1的运镜和转场效果,0-5秒镜头从全景缓缓推近到人物特写,5-10秒环绕镜头展示场景全貌,10-15秒镜头快速后拉至鸟瞰视角
1.5.3. 注意事项
- 素材多的时候,一定要检查每个 @ 有没有标清楚,别把图、视频、角色搞混
- 延长视频时,生成时长要选成"新增部分"的时长
- 没有音频素材也没关系,可以直接参考视频里的声音
- 按时间线写描述能让模型更精准地控制画面节奏

1.5.4. 五个实战模板,拿去直接用
1.5.4.1. 模板 1:电商产品广告
素材准备:产品正面图、侧面图、材质细节图各一张
提示词:
对 @图片2 的包包进行商业化的摄像展示,包包的侧面参考 @图片1,包包的表面材质参考 @图片3,要求将包包的细节均有所展示,背景音恢宏大气
1.5.4.2. 模板 2:短剧预告片
素材准备:角色参考图 1-2 张
提示词:
使用参考图片人物的形象生成一段古装穿越剧的预告短片。0-3秒画面:参考图片1人物形象的男主手里举起一个篮球,抬头望向镜头,说话"我只是想喝杯酒,该不会要穿越了吧……" 4-8秒画面:镜头突然剧烈晃动,场景切换成古宅的雨夜……
1.5.4.3. 模板 3:品牌宣传片
素材准备:场景照片 2-3 张,旁白参考视频 1 段
提示词:
根据提供的写字楼宣传照,生成一段15秒电影级写实风格的地产纪录片,旁白的音色参考 @视频1,拍摄"写字楼的生态",呈现楼内不同企业的运作
1.5.4.4. 模板 4:运镜复刻
素材准备:角色参考图 1 张,场景图 2-3 张,运镜参考视频 1 段
提示词:
参考 @图1 的人物形象,他在 @图2 的场景中,完全参考 @视频1 的所有运镜效果和主角的面部表情,镜头跟随主角奔跑,环绕到正面,再后拉展示全景
1.5.4.5. 模板 5:视频延长 + 广告收尾
素材准备:已有视频 1 段,品牌元素图 1-2 张
提示词:
将视频延长6s,出现电吉他的激昂音乐,视频中间出现"JUST DO IT"的广告字体后逐渐淡化,镜头上移,男人穿着 @图1 的紧身健身服,背面印有 @图2 的Logo
1.6. 避坑指南

别忘了 @:上传了素材但提示词里没有 @ 引用,等于白上传。模型不会自己去猜哪张图干什么用。
@ 别标错:素材多的时候最容易出问题。写完提示词后,花 10 秒钟检查一遍每个 @ 引用是不是对的。
延长视频选对时长:延长 5 秒就选 5 秒的生成时长,选长了会多生成不需要的内容。
参考视频别太长:总时长上限 15 秒,而且视频越短越精准。如果你只想参考某段运镜,截取那几秒关键片段就够了。
多生成几次:AI 生成天然有随机性,同样的输入跑三次可能效果差很多。别因为第一次不满意就放弃,多试几轮挑最好的。
先简单后复杂:如果你是新手,建议从"一张图+文字"开始,熟悉了再加视频参考和音频参考,循序渐进。
1.7. 写在最后
Seedance 2.0 刷屏不是没有道理的。它不只是画质变好了、动作更流畅了,更关键的是它改变了 AI 视频创作的交互方式。
通过多模态输入和 @ 引用机制,创作者第一次能够精准地告诉 AI “我要什么”,而不是写完提示词然后听天由命。
当然它还在持续进化中,有些极端复杂的场景可能还不够完美。但从目前的能力来看,它已经是一个真正能用在实际创作中的生产力工具了。
建议大家先收藏这篇指南,然后打开即梦动手试试。看别人的作品刷屏不过瘾,自己上手才是真的爽。
以上基于 Seedance 2.0 官方使用手册整理
1.8. 彩蛋
[!success] 核心要点
- 定位:字节跳动 Seedance 2.0(2026-02-12 发布,豆包/即梦接入),多模态视频生成模型,输入四模态(图片×9 + 视频×3 + 音频×3 + 文字,总 12 文件),输出 4-15 秒视频、自带音效配乐(参数多源核验一致)
- 核心操作:
@素材名引用机制分配任务(@图片1 定形象 / @视频1 参考运镜 / @音频1 配乐);两个入口——单图+文字走首尾帧,多模态走全能参考- 操作五步:选入口 → 上传素材 → @ 分配任务 → 写提示词 → 选时长生成
- 提示词黄金公式:
@素材 + 用途说明 + 具体画面描述 + 时间线(可选);按时间线分段、区分"参考/编辑"、镜头语言写具体、连续动作加过渡- 十一大能力:画质飞跃、多模态组合、一致性、运镜复刻、创意模板复刻、视频延长、真实声音、一镜到底、视频编辑、音乐卡点、情绪演绎
- 避坑六条:别忘了 @、@ 别标错、延长选对时长、参考视频 ≤15 秒、多生成几次、先简单后复杂