PDF 解析工具盘点
PDF 解析工具盘点
1. Doc2x
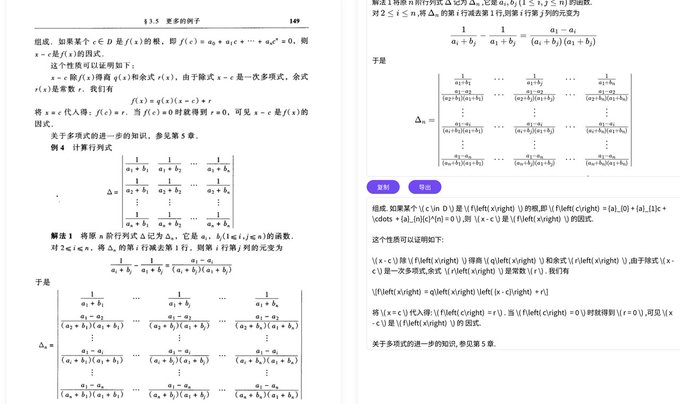
可以将 PDF 文件转换为 Markdown、LaTeX、DOCX,可解析排版、数学公式、表格、图片、图表等,对包含表格和公式的文档处理效果较好,国内的不少大模型厂商在使用,中英文文档处理效果比 Mathpix 好
2. gptpdf(开源)
只用 293 行代码,几乎完美地解析了排版、数学公式、表格、图片、图表等,上限是 gpt-4o 的能力,期待后续进一步的迭代
方法:使用 PyMuPDF 库,解析出 PDF 中的所有非文本区域并做好标记;再使用视觉大模型(如 GPT-4o)进行解析,得到 markdown 文件
3. RAGFlow(开源)
RAGFlow 是基于深度文档理解的开源 RAG(检索增强生成)引擎,为了解决幻觉问题,项目方在文档解析模块做了创新,采用了自创的 deep document understanding 方法。支持 Word、幻灯片、Excel、txt、图像、扫描件、结构化数据、网页等复杂的非结构化数据解析,包含各种不同场景模版,比如发票、简历、财报等
4. mathpix(据说 Claude 数学能力强因为用了 mathpix)
可以解析文本、数学、化学、手写识别、表格、外语和完整 PDF 文档,输出 LaTeX 、Markdown、Word 等格式。
支持类似谷歌的搜索功能
体验地址:https://mathpix.com
5. 庖丁 PDFlux
提取 PDF / 图片中的表格和文字,AI 智能生成摘要/搜索/改写/翻译
体验地址:https://pdflux.com
6. pix2text(开源)
支持多语言,可以识别图片中的版面、表格、图片、文字、数学公式等,输出 Markdown 格式。也可以把整个 PDF 文件(PDF 可以是扫描图片或者其他任何格式)转换为 Markdown
体验地址:https://huggingface.co/spaces/breezedeus/Pix2Text-Demo
github:https://github.com/breezedeus/Pix2Text
7. TextIn
可以识别文档或图片中的文字信息,按常见阅读顺序进行还原。支持标准的年报、文书、函件、合同等文档,兼容扫描文档和电子 PDF 文件
8. 腾讯云文档识别
可将图片或 PDF 文件转换成 Markdown 格式文件,包括表格、公式、图片和文本等,并按阅读顺序还原文档内容
9. marker(开源)
支持多语言多文档类型,针对书籍和科学论文做了优化
10. Paddle
通用表格识别是飞桨特色的端到端表格识别系统,可精准预测论文、报告等文档中的表格位置和内容
11. MinerU
核心组件
11.1 Magic-PDF
- 将 PDF 转换为 Markdown 格式
- 支持多种前端模型输入
- 将公式转换成 LaTeX
- 自动识别并转换乱码 PDF
- 保留原文档的结构和格式
- 排版符合人类阅读顺序
11.2 Magic-Doc
- 将网页或电子书转换为 Markdown 格式
- Web 网页提取可跨模态解析图文、表格、公式信息
- 支持 epub、mobi 等多格式文献,文本图片均适配
- 支持 176 种语言
更多信息请访问 GitHub - MinerU。