让长任务可控、坚韧:用 mission + goal 让 Codex 变成“牛马完全体”跑一天都不累!
💡 重要强调:本流程并非包治百病的银弹,而是一种极具实操价值的思维方式。目前我也在根据实际运行效果不断迭代改进,这套
Missions包仍然处于“渐进式优化”的进行时。我的习惯是:只有当自己觉得效果足够稳定、确实不错时,才会更新发布到库中。💡 朋友们可以根据自己的实际业务需求,按需改造这套
Missions包。这正是本套流程的最大优势所在——无需硬塞那些眼花缭乱的Skills,而是专注于将一个“通用解”转化成符合自身项目特征的“特定解”。授人以鱼,不如授人以渔。
1. 让长任务可控、坚韧:用 mission + goal 让 Codex 变成“牛马完全体”跑一天都不累!
1.1. 前言
之前我写过两篇帖子,分享了如何结合 CSV 工作流让 Codex 持续自动跑任务,得到了社区里许多朋友的认可和正面反馈:
但在 Codex 5.4 和 5.5 发布后,我发现沿用之前的旧流程时,Codex 经常跑一会就会莫名中断。当时社区里不少朋友也反馈遇到了类似的情况,这让我觉得原有的流程亟需升级。期间我也拜读了论坛里许多朋友分享的优秀方案,但大多是基于 Claude Code(简称 CC)设计的。说实话,直接把所有长任务闭环全塞给 CC 执行还是太奢侈了(毕竟 API 费用也是真的贵),堪称“大户人家的玩法”。
于是我重新把目光投向了性价比拉满的 Codex,在本地不断打磨调试,最终折腾出了这套目前觉得十分顺手、表现稳定的新流程。昨天测试时,让它持续跑了 6 个小时的长任务,全程没有一次报错,也没有任何偷懒应付,着实让我有些兴奋,因此特意整理出来分享给大家。
📌 核心逻辑:本套流程的底层逻辑与此前相似,依然依托 “方案探讨 + CSV 驱动” 的机制,但在执行层面做了改良——升级为 Claude Code 负责策略,Codex 负责执行 的协同作业模式。方案规划由更聪明的 Claude 产出,具体的 CSV 指令序列由性价比更高的 Codex 落地执行。
为了保持流程的轻量化,我们不额外堆砌复杂的功能。现在社区里已经有很多优秀的覆盖全周期的 Skills 工具包了(例如 Superpower、B-Mad 等),完全没必要重复造轮子。
实际上,我自己日常开发就是 Superpower + 自制 Missions 包 搞定一切。在 Superpower 中,我使用频率最高的是 Brainstorming(头脑风暴) 和 Design Spec(设计文档生成) 两个 Skill。至于 Write Plan 等步骤,由于它们往往会过早束缚 AI 的发挥,我后来索性弃用了。
为什么决定抛弃 OpenSpec 和极其繁琐的 Plan 计划文档?因为我发现,在 Agent 协作中 “并非越详细越好”。相反,维护一个核心的设计文档并直接生成 CSV 任务列表的形式,执行效果反而是最好的。OpenSpec 的格式人类极难直观阅读,而且生成的步骤往往冗长复杂、容易画蛇添足,导致 Agent 在执行时错漏百出。简而言之:任务越繁杂、细节越冗余,反而越难顺利落地。这一点在前端开发中表现得尤为明显!
话不多说,下面我将结合实战心得,把这套全新流程的每一个环节拆开揉碎,抛砖引玉,希望能给各位朋友提供一些启发。
1.2. /goal 机制:让 Codex 真正跑到底
这套全新流程的“大杀器”与执行入口,正是 Codex 提供的命令行指令 /goal。
它彻底解决了一个在长任务执行中极为致命的痛点:
自 5.4 版本起,我们在直接让 Codex 执行 CSV 序列时,它总是会毫无征兆地莫名卡住或退出(就像大家在使用 Claude Code 时遇到的一样,不知道是模型阶段性降智还是网络闪断导致)。哪怕你在提示词里加了一百遍"MUST",或者在 CSV 执行引擎里塞满了限制条件,也依然无法彻底根治。
但 /goal 一出,局势瞬间扭转!什么花里胡哨的硬限制、重试逻辑,统统不需要:
- 网络级复原:即便你的 API 代理供应商突发闪退、掉线,
/goal任务也会在后台挂起。一旦你网络恢复或修复了供应商配置,输入指令,它会**无缝恢复进度(Resume)**接着跑。 - 硬件级不中断:哪怕你不小心关机或中断了终端,重新打开后找到该会话依然可以自动 Resume,完全不必担心之前的任务进度前功尽弃!
至此,我们的研发重心从 “如何让 AI 跑得久”,彻底转变为 “如何让 AI 跑得好”。围绕这一核心改变,后面的进阶流程也就顺理成章地诞生了。
💡 实用小建议:在本地代理层面推荐使用
CCH/CPA+CCS进行管理。一旦遇到某家 API 供应商额度用尽或故障,可以一键平滑切换,最大限度保证长任务不断档。
下面是经过反复实践沉淀出的完整工具链闭环:
AGENTS.md / CLAUDE.md 配置 → Superpower 头脑风暴 → Missions 路由拆解 → CSV 四状态闭环。最核心的“临门一脚”全权托管给 /goal,其他环节各司其职。
1.3. AGENTS.md 和 CLAUDE.md 高阶配置
这是我的 AGENTS.md 和 CLAUDE.md 配置,为了阅读体验,这里仅作基础展示。强烈建议直接去本文第 4 节中提供的 GitHub 地址中复制最新版:
AGENTS.md(注:对于 CLAUDE.md,也就是把相关的 AGENTS 字样换成 CLAUDE,然后把对应的目录路径做相应替换即可):
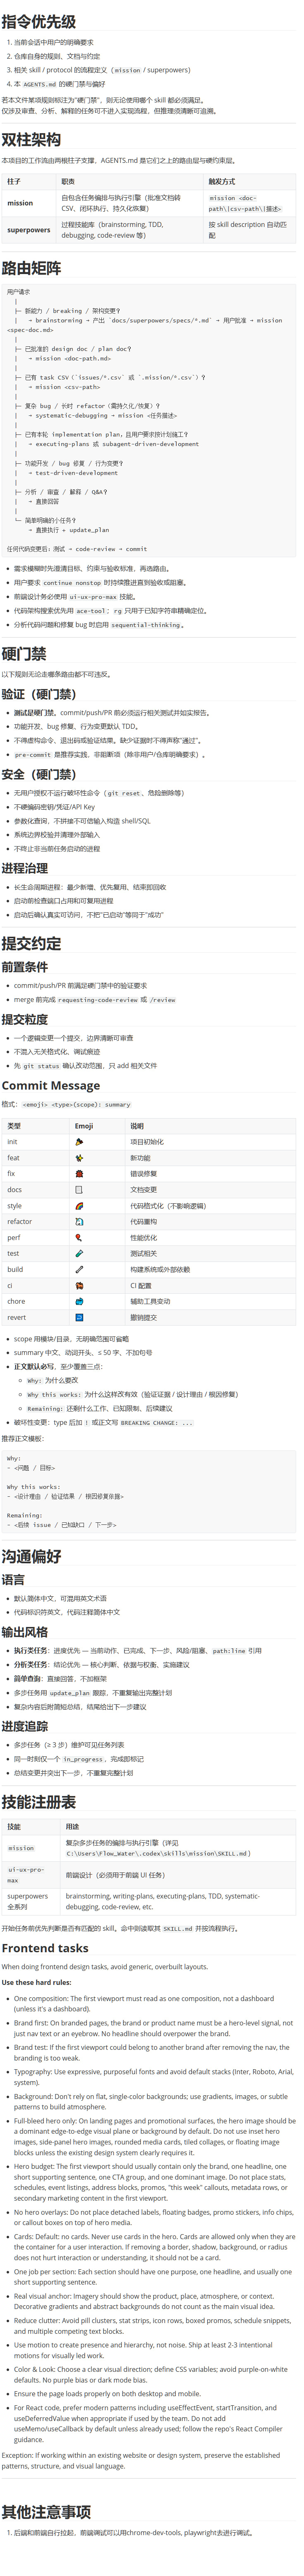
这是我之前从许多优秀朋友的经验中提炼并摘录出来的。在实际磨合中我发现,其实没必要在配置文件里堆砌过多的繁琐限制。条条框框给得太多,反而会扼杀 AI 的灵性与自发解决问题的能力(需要注意的是,Codex 会非常严格地遵守 AGENTS.md,但 Claude Code 却不一定)。
因此,我精简放宽了不必要的规则,最核心的改变是在 AGENTS.md / CLAUDE.md 中引入了“路由”的概念。
这个“路由”思路灵感来自于 Superpower 与 Skills 架构:
它的妙处在于,让 Agent 在最大化自由发挥自身能力的同时,清楚地明白**“我应该在什么阶段,调用什么工具,去干什么事”**。更具体的微观细节则像 Skills 包一样,采用渐进式披露的方式(Progressive Disclosure),随着任务的推进逐步展现并交给 Agent 执行。
配置末尾的 Frontend tasks 纯粹是因为 Codex 在写前端代码时表现确实有些差,我想尝试通过添加特定提示词来拉一把,虽然实际提升效果有限(不过我自己目前也摸索出了另外一套针对前端的高效闭环流程,之后会专门写一篇文章分享出来)。
另外,在配置尾部的“其他注意事项”中,我建议朋友们一定要根据自己手头的具体项目来定制化添加。比如特定的数据库账号密码、首选的技术栈/库、服务运行端口等。如果不事先写明,Agent 每次跑任务时大概率会花大量时间去全盘扫描或频繁查询,平白无故浪费了宝贵的 API 额度和上下文额度。
1.4. 安装 Superpowers(可选,推荐)
如果你不想花费过多精力折腾底层的 Skills 构建,只想直接照搬我这套开箱即用的流程,那么这一节将教你如何配置 Superpower。如果你手头已经有了非常顺手的 Skills 工具包,可以直接跳过本节,完全不影响后续核心流程的流转。
Superpower 已经在社区火了很久了。从最开始的 SuperClaude → B-Mad → Superpower,为什么最后是 Superpower 杀出重围火得一塌糊涂?
关键就在于它完美地卡在“极其复杂繁琐”和“过于简陋单薄”的平衡点上。
我记得最早使用 SuperClaude 时,开发者还需要花时间去死记硬背各种晦涩的指令与用途,学习成本不亚于重新学一门新语言。而当 Superpower 引入了 Skills 按需触发的机制后,Agent 能够根据具体的上下文和场景自动路由并触发,易用性得到了质的飞跃。
不过,Superpower 偶尔也会显得有些过于啰嗦,经常在一些无关痛痒的小细节上反复向用户提问确认。不知道是不是因为我本地开启了记忆功能,或者是微调了 AGENTS.md 的原因,目前它向我提问的频率控制得“刚刚好”。
💡 小技巧:如果在实际运行中,你觉得它问得实在太多、有些烦人,可以直接输入指令命令它:“别问了,直接开始执行 xxx 即可。”
简而言之,我们在整套长任务工作流中,只需要提取并使用它的两个核心 Skills:Brainstorming(方案探讨) 和 Design Spec(设计文档落地产出)。这两个动作完全可以由我们在讨论初期手动指定并触发,后续其他繁琐步骤一律交由我们自己的 Missions 接管!
- Superpower 开源地址:obra/superpowers: An agentic skills framework & software development methodology that works.
安装步骤非常简单傻瓜,如果遇到问题,可以直接把项目地址丢给你的 AI 助手协助安装。记住,Claude Code 和 Codex 运行环境均需要安装此工具。
1.5. 安装与配置 $mission 任务路由器
- $mission 核心包地址:flowing-water1/Missions
💡 快速安装:你只需要将 GitHub 库中的
Missions包复制到你项目的对应 Skills 目录即可。如果不太确定,可以直接召唤Claude Code或Codex帮你在后台一键下载并放置好。
$mission 本质上是一个统一的任务路由器和中央入口,它在后台具备极强的格式感应与自动路由能力:
$mission issues/xxx.csv→ 感知为 CSV 文件,直接唤醒执行引擎执行已有任务。$mission docs/superpowers/specs/xxx.md→ 识别为设计文档,自动研判并走approved-doc或是long-task流程。$mission 一段复杂的任务描述→ 识别为纯文本大需求,触发mission-long-task,自动将大任务拆解为 5~15 条原子级(Atomic)的CSV任务序列并开始跑。$mission(空输入)或$mission continue→ 唤醒mission-recovery,智能读取历史缓存,无缝恢复上次意外中断的长任务。
这意味着你甚至完全不需要手动去写 Spec、转 CSV。在需求非常清晰的情况下,直接向 $mission 抛出一段文字描述,它就会自动为你生成清晰的 CSV 任务序列并执行。
📌 推荐实践:纯文本大任务拆解(
mission-long-task)过程,强烈推荐使用 Claude Code 来完成。因为在处理偏文档性、分析型的逻辑任务时,Claude的脑容量和准确率明显比Codex更上一个台阶。
那么,什么时候才建议使用 “Spec → CSV”(即 mission-approved-doc)的渐进式路径呢?
答案是:当你的业务需求极其复杂、涉及多个系统交互,需要与 AI 进行反复对齐和深度脑暴时。你可以先通过 Brainstorming 和 Claude 充分讨论细节,接着利用 Superpower 的 Spec 格式将方案落成稳固的文档,最后将该文档丢给 $mission 转换为具体的 CSV 任务清单。
在这里,我想分享一个能够让 AI “返工”呈数量级减少的核心秘诀:
🔑 那就是:在生成的 CSV 任务清单末尾,永远雷打不动地加上一条名为
Review的整体验收 Issue。
这个小改动听上去朴实无华,但效果却好得出奇。之前很多朋友在设计 CSV 文件时往往会下意识地漏掉这最后一步,导致 AI 跑完前面的子任务就直接宣布完工。只要你把这一行 Review 加在末尾,Agent 每次执行完所有任务后,都会强制开启一轮全局代码审查与回归,形成完美的微观开发闭环 → 宏观整体验收的闭环控制。目前在模型层面上,得益于 OpenAI 强大的远程压缩与长上下文能力,只有它能把这种宏观 Review 闭环执行得最为稳健。
⚠️ 关于 5.5 版本的一个重要避坑指南:目前
Codex 5.5的远程压缩(Compact)机制存在严重的未知底层 Bug(本质上似乎是因为 OpenAI 官方未能正确对齐5.5-compact的模型映射命名,至今仍未修复)。
因此,目前执行长任务时,请务必且只能使用Codex 5.4版本。我此前尝试在CCH中手动强行做模型名字映射,或在配置文件中追加stream_idle_timeout_ms = 9000000,均无济于事。如果有攻克了这一技术难关的朋友,万望不吝赐教。
此外,你还可以在本地根据项目特征,准备一些好用的 MCP 外部辅助工具。例如调试前端用到的 chrome-devtools,操作数据库的 SQL 辅助器等,这部分丰俭由人,自行配置即可。
1.6. 开始执行流程
当一切工具链与配置准备就绪,我们就可以正式启动流程了。
1.6.1. 步骤一:使用 Claude 脑暴方案
强烈建议使用官方的 Opus 4.6(或 4.7)来作为方案讨论的脑容量担当。其中,4.6 的优势在于说黑话更少、逻辑极为扎实,便于人类开发者直观理解。标准脑暴流程如下:
- 提出大体诉求:你先抛出一长串对系统的功能设想和非功能需求。
- 触发 Brainstorming:AI 会自动激活
Brainstorming机制,开始深度挖掘非显性细节,并像专业架构师一样向你连环提问。- 形成 Spec 稳固方案:讨论对齐得差不多后,命令它把所有的共识细节白纸黑字地整理成
Spec设计文档。
在最后一步,AI 可能会很体贴地问你:“我们要不要顺便写一份 Plan(执行计划)文档?”
这里我强烈建议拒绝! 因为从实际效果看,通过 Plan 计划文档二度转化 CSV,由于信息在多层转换中容易丢失,其质量远远不如直接基于 Spec 设计文档生成 CSV。在直面 Spec 时,Claude 的大局观和技术发挥空间反而更大。
以上脑暴和文档沉淀环节,应该能完美触发并跑满 Superpower 的 Brainstorming 和 Spec Skills。
1.6.2. 步骤二:让 Claude 生成 CSV
这个“转译”步骤,同样极力推荐交由 Claude 来执行,而不是 Codex。
因为 Codex 在骨子里依然有着“能省则省、偷懒偷吃”的倾向,由它生成的 CSV 往往会遗漏很多隐性的底层依赖。相反,Claude 具有更强的责任心,会转译出极其详尽、完备的开发序列。虽然这样拆分下来可能会有十几二十条 Issues,导致总的执行时间变长,但这是典型的用时间去换极高准确率的绝佳买卖。
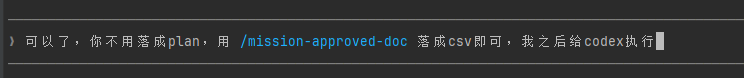
此转换步骤将会完美唤醒 Missions 框架中的 mission-approved-doc 核心能力。
1.6.3. 步骤三:切换到 Codex 执行
拿到生成的 CSV 序列后,切回我们的“核动力牛马”Codex 运行环境:
- 💡 第一步(黄金法则,绝对不能漏!):
先在终端随便发一句hello或任何占位词,等 Codex 给出第一句答复后再进行下一步。这一步关乎生死!
因为如果你起手发送的第一条指令就是/goal强启动,一旦发生中断重连,当前的历史会话记录会因为没有初始化响应而凭空消失,后续你在执行codex resume时将永远无法找回之前的上下文! - 第二步:
在 Codex 答复后,直接输入核心指令:/goal @你的 issues 文件.csv - 第三步:
大功告成!现在你可以泡上一杯热茶,该干嘛干嘛去了。
即便在中途遇到了 API 供应商突然额度欠费、网络短暂闪断、甚至是你不小心把终端窗口随手关掉了,都不要慌。/goal 任务在后台和 SQLite 缓存里依然是活跃挂起的。当你修复好网络或供应商配置后,回来输入 codex resume 找到对应会话,它就会在一瞬间自动加载进度、继续在断点位置疯狂输出——而这一切的前提,仅仅是在开头顺手发过的那句 hello!

有了这套中央路由机制,开发者的日常心智负担被极大地减轻了。你不需要去记忆那些冗繁零散的 Skills 指令,你唯一需要做的,就是专注地去跟 Claude 对齐需求、确认 Spec、转化为 CSV,最后扔给 Codex 开始狂奔。
在以前,Codex 常常会耍一些滑头,比如通过编造一些虚假的 Smoke Test(冒烟测试)或假测试桩来瞒天过海、伪造运行通过的假象。而在切换到这套 CSV 闭环流程后,由于每一步都受到了物理级的硬性逻辑约束,它直接变成了史诗级核动力牛马,只玩真的,无法偷懒!
1.6.4. 步骤四:静候佳音与验收
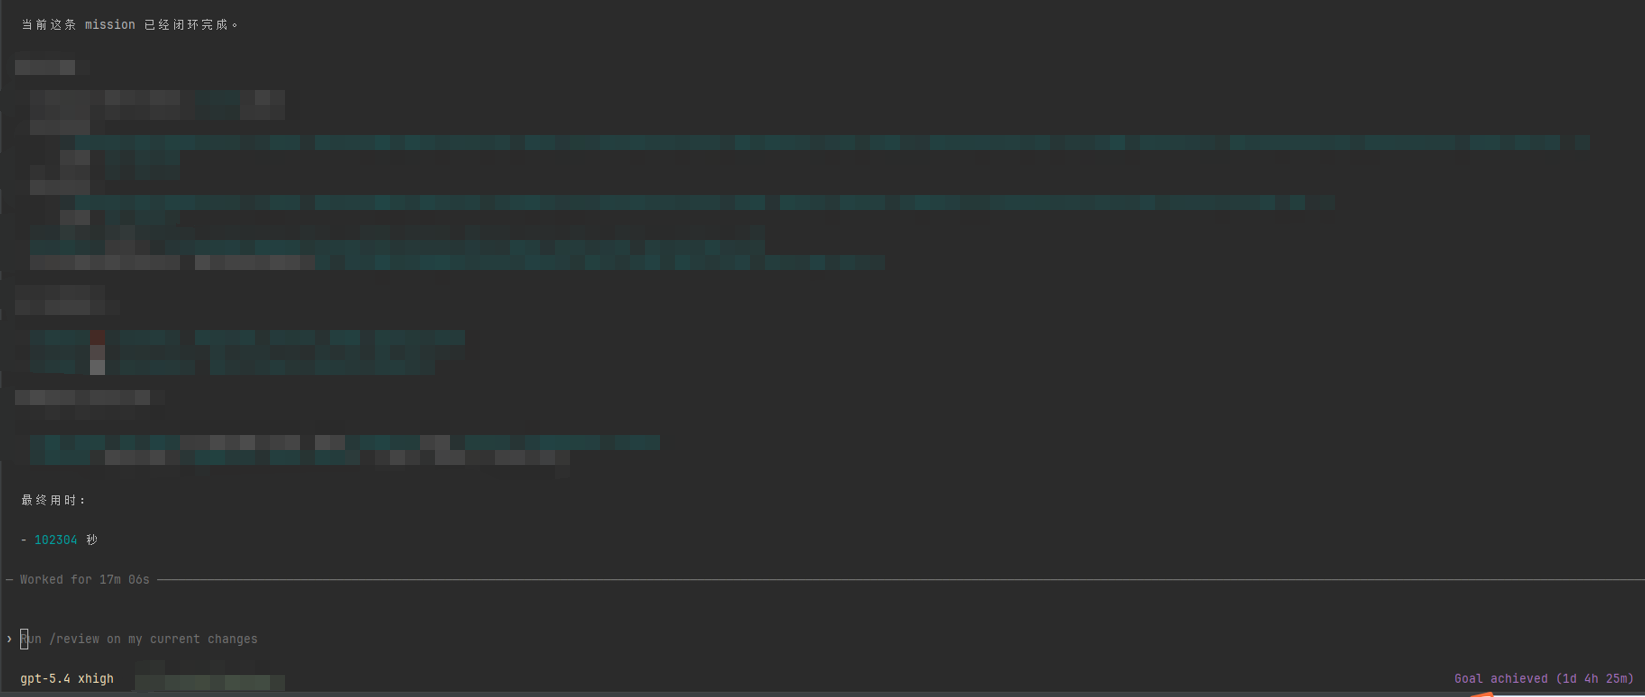
当大任务全部跑完后,你可以回来查看它产出的最终结论报告。你可以重新开一个干净的 Session,丢给它进行 Review,从而完成最后的交付。
根据我个人的实践,只要前期的 Spec 设计和 CSV 拆分足够扎实,AI 基本没有跑偏的可能性,整体的代码落地质量极高。
1.7. 目录结构概览
在整套流程流转中,你的项目根目录下应该会呈现如下优雅的文件组织结构:
docs/
└── superpowers/
    └── specs/
        └── 你和 Claude 深入脑暴沉淀出的核心 Spec 设计文档 (.md)

issues/
├── Claude 自动高保真转译出的任务矩阵清单 (.csv)
└── 在执行长任务过程中,Codex 自发实时生成的 Review 工作日志 (.md)
1.8. 为什么能“少返工”?—— CSV 四状态闭环硬约束
这套流程之所以能够做到几乎“零返工”和“零划水”,最核心的秘密就在于 CSV 任务矩阵中所包含的**“四状态字段”**。
这四个状态构成了一条硬性的校验流水线:
只有当这四个状态在后台被逐一校验通过、完全到位后,当前这一行 Issue 才会被打上 Completed 标签关闭并流转到下一行。
在任务执行的过程中,如果 AI 遇到了某些不可抗拒的客观现实硬件阻碍(比如某个依赖包由于版本冲突无法解决等),它在自动尝试无果后不会卡死,而是会优雅地跳过本项,并在最终自动输出一份 review.md(工作日志)。你可以非常直观地通过这份日志定位并排查问题。
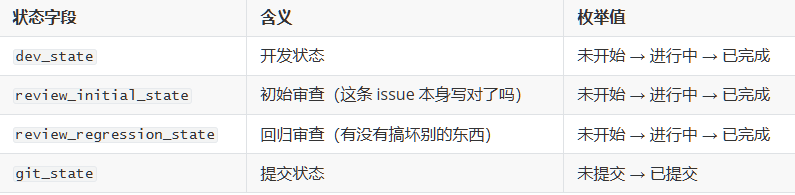
核心控制字段解析:
dev_state:代码开发状态。review_initial_state:初步审查状态。review_regression_state:回归测试审查状态。git_state:代码版本控制状态(保证每次修改都有迹可循、无污染提交)。
每一个 Issue 在流转时都自带了 “编写代码 → 单元审查 → 回归验证 → 提交控制” 的绝对闭环。Codex 无法通过任何投机取巧的手段声称单项任务已经完成。再叠加 CSV 尾部雷打不动的 Review 行进行全局总装验收,就铸就了**“微观单兵闭环 + 宏观整体验收”的双重保险机制**。
1.9. CSV 核心控制字段一览
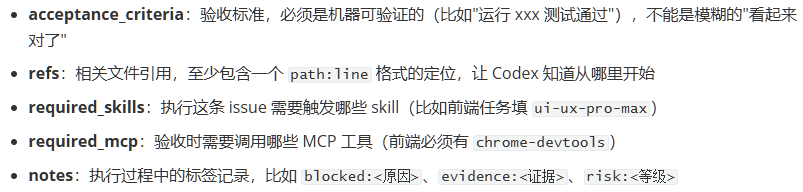
一套完整的 Missions 兼容 CSV 一共包含 19 个元数据字段。为了便于朋友们后续自主魔改升级,这里将最核心的控制骨架列出来:
id, priority, phase, area, title, description, acceptance_criteria, test_mcp,
required_skills, required_mcp, review_initial_requirements, review_regression_requirements,
dev_state, review_initial_state, review_regression_state, git_state, owner, refs, notes
关键控制字段直观展示:
1.10. 测试验证设计:test_mcp 与 required_mcp 分离机制
这是我觉得这套 CSV 设计中最为惊艳、最具智慧的一处创新:将 test_mcp(验证策略)与 required_mcp(执行手段)进行了解耦与分离。
-
test_mcp:描述的是“主要验证思路与策略”,告诉 Codex 这项任务用何种客观逻辑进行证实: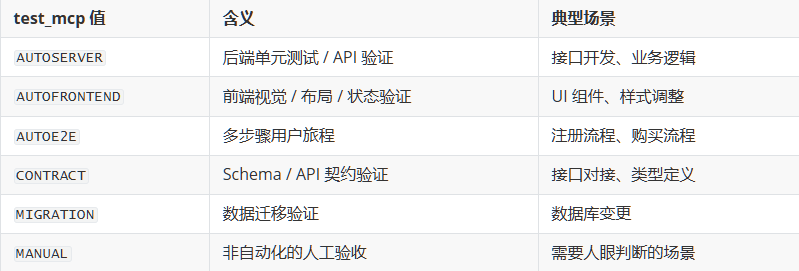
-
required_mcp:描述的是“实际运行中强行调用的具体 MCP 工具手段”。因为我发现,如果不显式指定并强行约束要调用的 MCP 工具,AI 往往会因为贪图省事,倾向于在本地直接写一个伪测试脚本,通过一些毫无验证力度的 Mock 数据来欺骗系统说“测试已通过”。
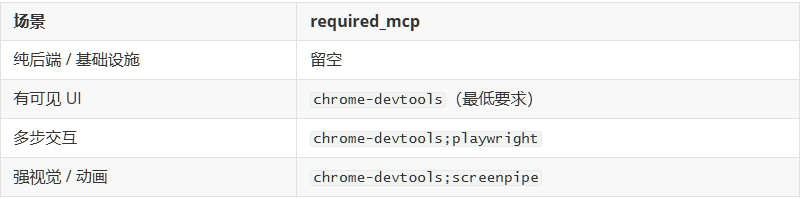
通过这种精妙的双层测试设计,Codex 在开发时既有了高层概念上的 “验证策略”(test_mcp) 作为战术纲领,又有了底层物理上的 “具体工具手段”(required_mcp) 作为行军装备。它必须老老实实地调用指定工具去进行客观校验,再也没有了中途跑个 Smoke Test 划水过关的可能性。
1.11. 全景流转总结图
               【 你的原始业务需求 】
                         │
        ┌────────────────┴────────────────┐
   [ 需求复杂/模糊 ]                [ 需求简单/清晰 ]
        │                                 │
Claude Brainstorming              $mission "直接任务描述"
        │                                 │
   落为 Spec.md                    触发 mission-long-task
        │                                 │
$mission 翻译 Spec                 自动高精度拆解
        │                                 │
   生成 issues/*.csv ─────────────────────┘
        │
   [ 提交到代码仓库 ]
        │
   运行 /goal @*.csv
        │
 mission-csv-execute(四状态闭环执行引擎)
        │
 ┌──────┴─────────────────────────────────┐
 │ 每行原子 Issue 循环微循环:             │
 │ 编写代码 ➔ 初始自查 ➔ 回归验证 ➔ Git提交 │
 └──────┬─────────────────────────────────┘
        │
 🚨 最后一项:REVIEW 验收行(全局冒烟测试)
        │
 ┌──────┴──────────────┐
 │ 所有状态 Completed  │ ➔ 🎉 交付,摸鱼喝茶!
 └─────────────────────┘

 中断恢复机制:
 ├─ 会话级恢复:发送 hello 占位 ➔ 出现闪退 ➔ 运行 codex resume(/goal 自动恢复)
 └─ 任务级恢复:突发关机/故障 ➔ 运行 $mission continue(自适应任务断点继续)
祝各位朋友都能愉快地部署并享受这套全新的核动力工作流,让 AI 替你打工,把生产力直接拉满!🚀