为什么 Claude Code 这么牛?
[!info] 阅读导览
全文共 8 章:引言 → 架构哲学(拒绝复杂)→ 模型分工(小模型有大用)→ 语境注入(claude.md)→ 提示工程(XML 标签与流程化提示)→ 搜索观(LLM Search 胜过 RAG)→ ToDo 清单管理 → 写在最后
1. 引言
这两天正好刷到一篇博客,详细拆解了为什么 Claude Code 如此出色。
我认为这篇博客非常值得反复阅读,无论是对使用 Claude Code 还是构建 Agent 系统都很有帮助。
原文地址:Decoding Claude Code
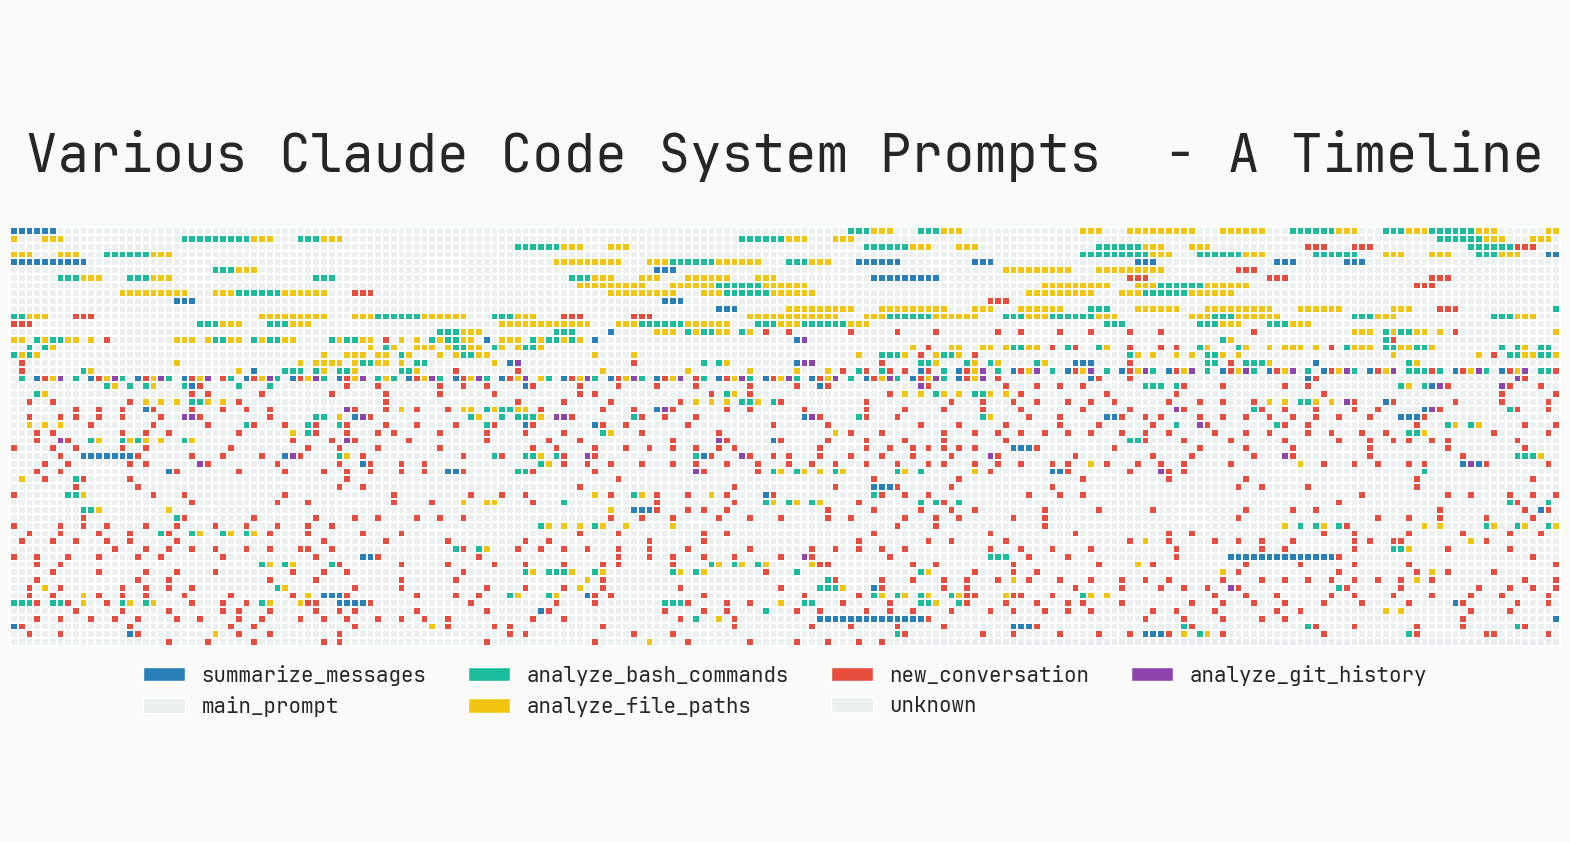
我对原文进行了梳理和总结,希望能帮助你更好地理解 Claude Code 的设计思想。
2. 架构哲学:拒绝复杂
Claude Code 没有采用非常流行的多智能体编排,它的核心是一个主循环再加上最多一个子分支。换而言之,整个 Agent 系统始终维持一条扁平的消息交互链。当任务需要分解时,主 Agent 只会克隆一个子 Agent 来处理子问题,其结果作为工具响应添加到主线程的对话历史记录中。
我觉得 Anthropic 这帮人真的非常擅长构建 Agent,而且他们并不迷信于某一种 Agent 架构。虽然 Claude Code 没有采用多智能体架构编排,但是并不代表他们完全放弃这一架构。他们在构建深度研究这个 Agent 的时候,采用的就是多智能体架构进行编排。
flowchart LR
    U[用户请求] --> M[主 Agent 主循环]
    M --> T{任务复杂度}
    T -->|足够简单| TOOL[调用工具直接解决]
    T -->|足够复杂| SUB[克隆子 Agent<br>结合 ToDo 清单拆解]
    SUB --> R[结果回填主线程<br>对话历史]
    R --> M
    TOOL --> M
简单来说,这个 Agent 系统架构的逻辑就是:如果问题足够简单,主 Agent 就会自己用工具解决;但是如果问题足够复杂,主 Agent 就会克隆一个自己,作为子 Agent 结合待办事项列表拆解复杂问题,一个个完成。
这个架构最大的优势就是没有无限套娃、方便调试以及足够稳定。多智能体系统虽然很强大,但是每增加一个子 Agent,整个系统的调试难度呈指数级上升,而且非常容易出现不同子 Agent 互相踢皮球的混乱局面。
所以,在设计 Agent 系统的时候,一定要秉持着一个核心原则:可调试性 >> 花哨的链路编排
3. 模型分工:小模型有大用
与我们日常使用不同的是,小模型在整个 Agent 系统中,有很大的作用。
实践中,50%+ 的关键 LLM 调用都给了更便宜的小模型,比如 Claude-3.5-haiku。这类模型一般都用来读取大文件、解析网页、处理 git 历史、对话长文总结这类高频但是不复杂的任务。
小模型相比于主流的大模型要便宜 70%-80%。
所以,在设计 Agent 系统的时候,第二个核心原则就是:能省就省,把预算留在真正需要花费的地方,比如需要深度推理阶段。
4. 语境注入:运用好 claude.md
Claude Code 利用 claude.md 来作为上下文记忆载体,来存储并应用用户偏好和项目背景知识。在每次对话交互时,Claude Code 都会自动将工作目录下的 claude.md 文件内容作为用户提示的一部分送入模型。
换句话说,用户可以在 claude.md 中写入各种偏好、规则和说明,Claude Code 会把它当作对话上下文牢记。
那 claude.md 一般都是写什么呢?
一般来说,几乎任何你希望 AI 牢记的信息都可以放进去。
比如:常用的命令、代码风格、测试步骤、需要避开的陷阱等等。当首次在项目中运行 /init 命令时,Claude Code 会自动扫描项目,生成一个初始的 claude.md;更重要的是,可以据此手动增加或者删除内容,定制化地加入用户需要的代码规范和偏好。
由于 Claude Code 每次处理请求都会发送完整的 claude.md 内容给模型,因此模型始终都在用户的偏好和指导下行动。
得益于 claude.md,用户不需要每次对话都重复强调上下文,来让模型重复学习和记忆。所以这也是为什么 Claude Code 效果如此好的原因之一。
5. 提示工程
Claude Code 的系统提示非常长:系统提示正文部分就有 2.8k 的 tokens,工具调用有 9.4k 的 tokens。用户通常还会额外附带 1-2k tokens 的 claude.md。整个上下文非常的庞大,真的体现出了 Anthropic 在系统提示词方面的一个信条:
只要能提升模型表现,就应该尽量提供充分完整的上下文。哪怕提示词很长也无妨。
如果你看过大量 Anthropic 给 Claude 的提示词,就会发现,他们非常喜欢使用 xml 标签结合 Markdown 来进行编写,来要求最大限度的规范模型的行为。
首先,XML 样式的标签被用于提示的各个部分,起到元指令的作用。其中比较特别的是下面这两类标签:
1. <system-reminder>(系统提醒标签)。在很多提示段落末尾,会加上这样的提醒,提示模型一些容易遗忘的要求。例如像下面这段提示:
<system-reminder>This is a reminder that your todo list is currently empty. DO NOT mention this to the user explicitly because they are already aware. If you are working on tasks that would benefit from a todo list please use the TodoWrite tool to create one. If not, please feel free to ignore. Again do not mention this message to the user.</system-reminder>
这类提醒信息被嵌在 <system-reminder> 中,模型会将其视作系统指令而不向用户明说,从而强化了内部约束,却不干扰模型给用户的正常回复。
2. <good-example> 和 <bad-example>(正反示例标签)。它们在 Claude Code 中的作用是给模型提供行为示范。当面对一个有多种做法的情境时,系统提示词里往往会展现正确做法的例子和错误做法的例子,帮助模型明确应该选择哪种路径。例如,用户可能希望 Claude Code 不要频繁更改工作目录,就提供了如下示例:
Try to maintain your current working directory throughout the session by using absolute paths and avoiding usage of `cd`. You may use `cd` if the User explicitly requests it.
<good-example>
pytest /foo/bar/tests
</good-example>
<bad-example>
cd /foo/bar && pytest tests
</bad-example>
通过这样的对比,模型在决策时就更清楚什么样的行为应该规避,应该选择什么样的行为。可以将正反示例相当于小型的训练样本,在提示阶段对模型的行为进行微调。
其次,Claude Code 大量使用 Markdown 标题将提示分割成清晰的部分。例如系统提示词中使用 # 或者 ## 标题划分出语气与风格、主动性、遵循约定、代码风格、任务管理、工具使用政策、执行任务、工具列表等模块。
这些模块方便模型理解不同信息的侧重点,降低因提示杂乱而引发冲突的概率。
在提示内容上,Claude Code 的系统提示词中还堆叠了大量的实例、规则和提醒词汇来提醒模型。例如:
1. 大量重要提示词:为了强力规训模型,系统提示词中频繁出现 IMPORTANT、VERY IMPORTANT、NEVER、ALWAYS 这样的词汇。虽然看上去不是很优雅,但是当前最有效让模型别做某事的最好的方法仍然是反复强调,该唠就唠。
2. 明确的决策流程:Claude Code 的系统提示词中写下了执行任务的算法伪代码。也就是说,它没有简单列出零散的要求,而是按照任务流程,把模型该遵循的步骤、检查点都描述出来了。
比如在任务管理、执行任务、工具使用策略等章节,提示会逐步讲解模型接到用户请求后应如何分析任务、什么时候列出 todo 清单、什么时候调用哪个工具、完成后如何验证,几乎等于手把手的给模型制定了一个流程图。
这种做法的最大的好处就是避免了提示词变成了大量零碎的该做、不该做列表。通过流程化、结构化的提示,Claude Code 确保模型始终按照预定逻辑行事,大大提升了可靠性。
6. 搜索观:LLM Search 胜过 RAG
正如之前很多文章分享的那样,Anthropic 在做 Claude Code 的时候用的不是 RAG 来对代码进行检索。
传统的 RAG 算法需要先将代码片段向量化,构建向量数据库检索相关内容、再将结果提供给模型。但这种方案问题很多:一方面代码一旦改动就要重新生成索引,实时性非常差,不适合频繁变动的开发场景;另一方面,整个 RAG 过程每一步都存在着坑,比如:相似度函数怎么选、如何切分代码等等,稍有不慎就可能让模型检索到错误的代码信息。
Claude Code 的方法是不建立任何向量库,不做离线嵌入,而是赋予模型调用系统原生工具,比如 rg、grep、find 这些,直接在代码库中搜索。举个例子,当用户询问项目哪里定义了 UserService 接口时,模型会调用 Grep 工具在整个仓库搜索关键字,返回匹配行,然后再由模型判断哪些结果相关,并读取文件细节。
这种纯粹基于 LLM+工具的检索有几个明显的优势:
即需即取,实效性高。不需要先预备索引,模型每次在最新代码上执行搜索,因此能实时反映仓库的变化。这对日常开发中代码频繁变更来说非常关键。
实现简单,减少故障点。减少了向量数据库、嵌入模型、重排序算法等中间环节,大大降低了系统的复杂度。模型自身理解的代码能力很强,完全可以借助正则等直接定位相关代码片段。这样一来,整个 Agent 少了很多黑盒步骤,更易于调试和改进。
可学习。由于检索过程也是由主模型控制并可见的,未来这些工具调用数据可以用强化学习,让模型更聪明地学会搜索。
这其实也是为什么 Claude Code 这么贵的原因,一次上下文就要送超级多的 Token,能不贵么。
7. 稳定任务目标与 ToDo 清单管理
长时间、多步骤的交互中,大部分 Agent 最常见的问题是上下文遗忘或目标漂移。一开始雄心勃勃的规划任务,聊着聊着可能就跑题了,或者陷入了死循环。
Claude Code 针对这类问题的解决方案是让模型自己构建一份 ToDo 清单,并提供一个 TodoWrite 的工具,允许模型记录当前待办事项列表。系统提示词中则明确要求模型频繁检查和更新这份列表。当模型接到复杂任务时,它会主动把任务分解成若干步骤写入 ToDo 清单,然后按次序逐一解决,并在必要时动态调整列表。
整个过程中,没有引入第二个指导模型,一切规划与执行都出自同一个大模型,这意味着模型既有目标管理机制,又保留了自主调整的余地。
这一切都得益于 Claude 模型的强大。它可以实行交错思考,也就是一边写代码,一边思考,反思当前步骤没有跑偏掉,保持对最终目标的追踪。
这种自我管理的 ToDo 的方式有几个显著的优点。首先,它避免了多智能体架构中的信息损失和沟通成本,以最简洁的方式实现了任务分解与监督。其次,由于 ToDo 列表对用户也是可见的,在体验上对用户非常友好。而对于模型来说,ToDo 列表像是一个长期记忆,即使对话历史裁剪或上下文变长,它仍有固定的位置提醒模型,当前还有哪些任务没有做完。许多 Agent 会存在长对话遗忘当前目标的情况,在 Claude Code 中大大减少了。
8. 写在最后
虽然我一直对 Anthropic 这个公司封禁国内用户账号的这种做法非常嗤之以鼻,但是有一说一,它们家做的产品是真牛逼,特别是在代码这块。他们所有的博客、论文、播客我觉得都值得反复观看阅读很多遍。
回到 Claude Code 上来说,他们的 Agent 系统设计的是真的很厉害,用一个词概括就是大道至简。整个系统架构可扩展性非常强。越牛逼的东西,背后的设计理念反而越简单。相反,过度复杂的架构反而越容易出问题。
所以,大家在进行 Agent 设计的时候,一定要仔细思考什么才是真正必要的部分。最核心的一定是强大的模型作为底座、本质的任务,以及直接明了的策略。在这些基础上尽可能地做减法,才能让我们的 Agent 系统走得更稳、也更远。
[!success] 核心要点
- 架构哲学:单一主循环 + 最多一个子分支,可调试性优先于花哨编排
- 模型分工:50%+ 的 LLM 调用交给小模型,节省 70%-80% 成本
- 语境注入:claude.md 自动注入用户偏好与项目背景,
/init生成初始版本- 提示工程:长提示 + XML 标签(system-reminder、正反示例)+ 流程化决策步骤
- 搜索观:不建向量库,用 rg/grep/find 等原生工具即需即取
- 任务管理:单一模型自建 ToDo 清单(TodoWrite),避免目标漂移