AI代理的上下文工程:构建Manus的经验教训
1. AI 代理的上下文工程:构建 Manus 的经验教训
作者:Yichao ‘Peak’ Ji | 发布日期:2025/7/18 | 分类:技术
1.1. 引言
上下文工程绝非易事
这是一门实验科学——我们已经重建了我们的代理框架四次,每次都是在发现了更好的塑造上下文的方式之后。
我们亲切地将这种手动架构搜索、提示调整和经验猜测的过程称为"随机研究生下降"(Stochastic Grad Student Descent)。
这并不优雅,但它有效。
1.2. 围绕 KV 缓存进行设计
1.2.1. KV 缓存的重要性
在典型的 AI 代理工作流中(如下图所示),输入与输出 token 的比例高度倾斜。
以 Manus 为例,其平均输入/输出 token 比例约为 100:1。
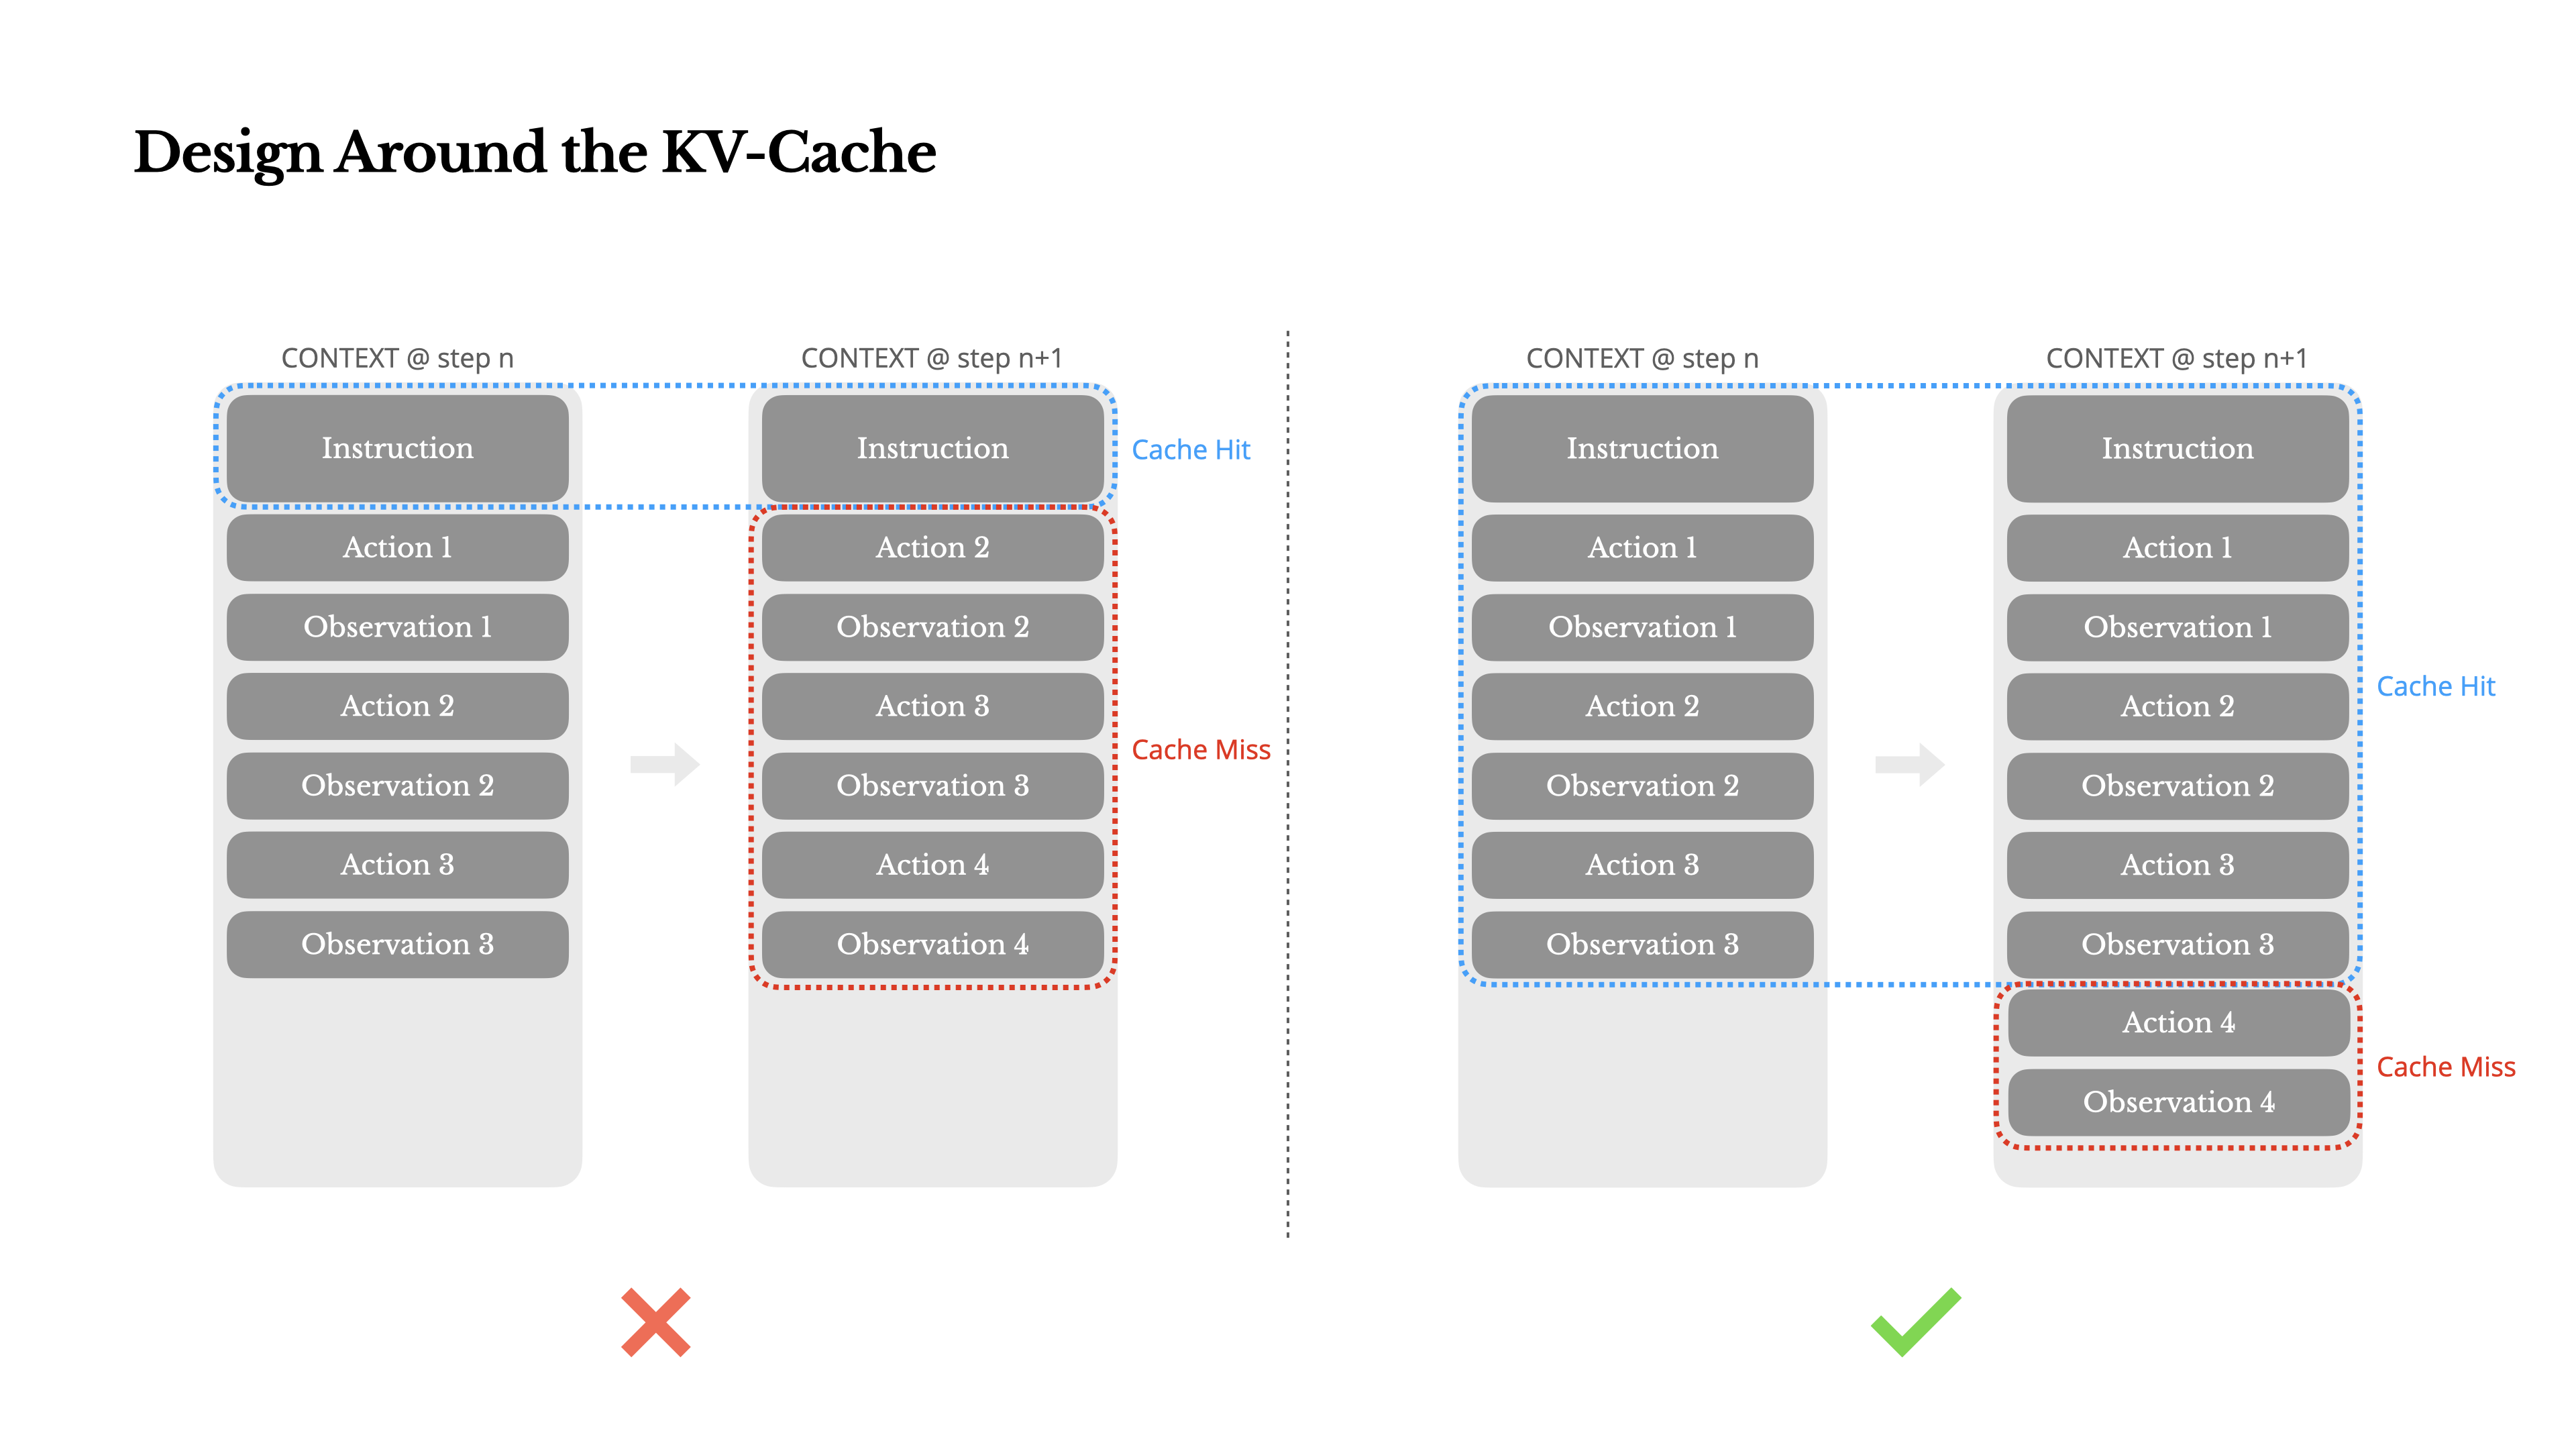
1.2.2. 提升缓存命中率的实践
-
保持提示前缀稳定
- 避免在系统提示中包含秒级时间戳等易变动内容
- 推荐使用固定格式的日期表示(如 YYYY-MM-DD)
-
保持上下文只追加特性
- 避免修改历史操作记录
- 使用确定性序列化方法(如按键名排序的 JSON)
-
合理使用缓存断点
- 在系统提示结束处标记缓存边界
- 使用会话 ID 实现分布式缓存路由
1.3. 上下文管理进阶技巧
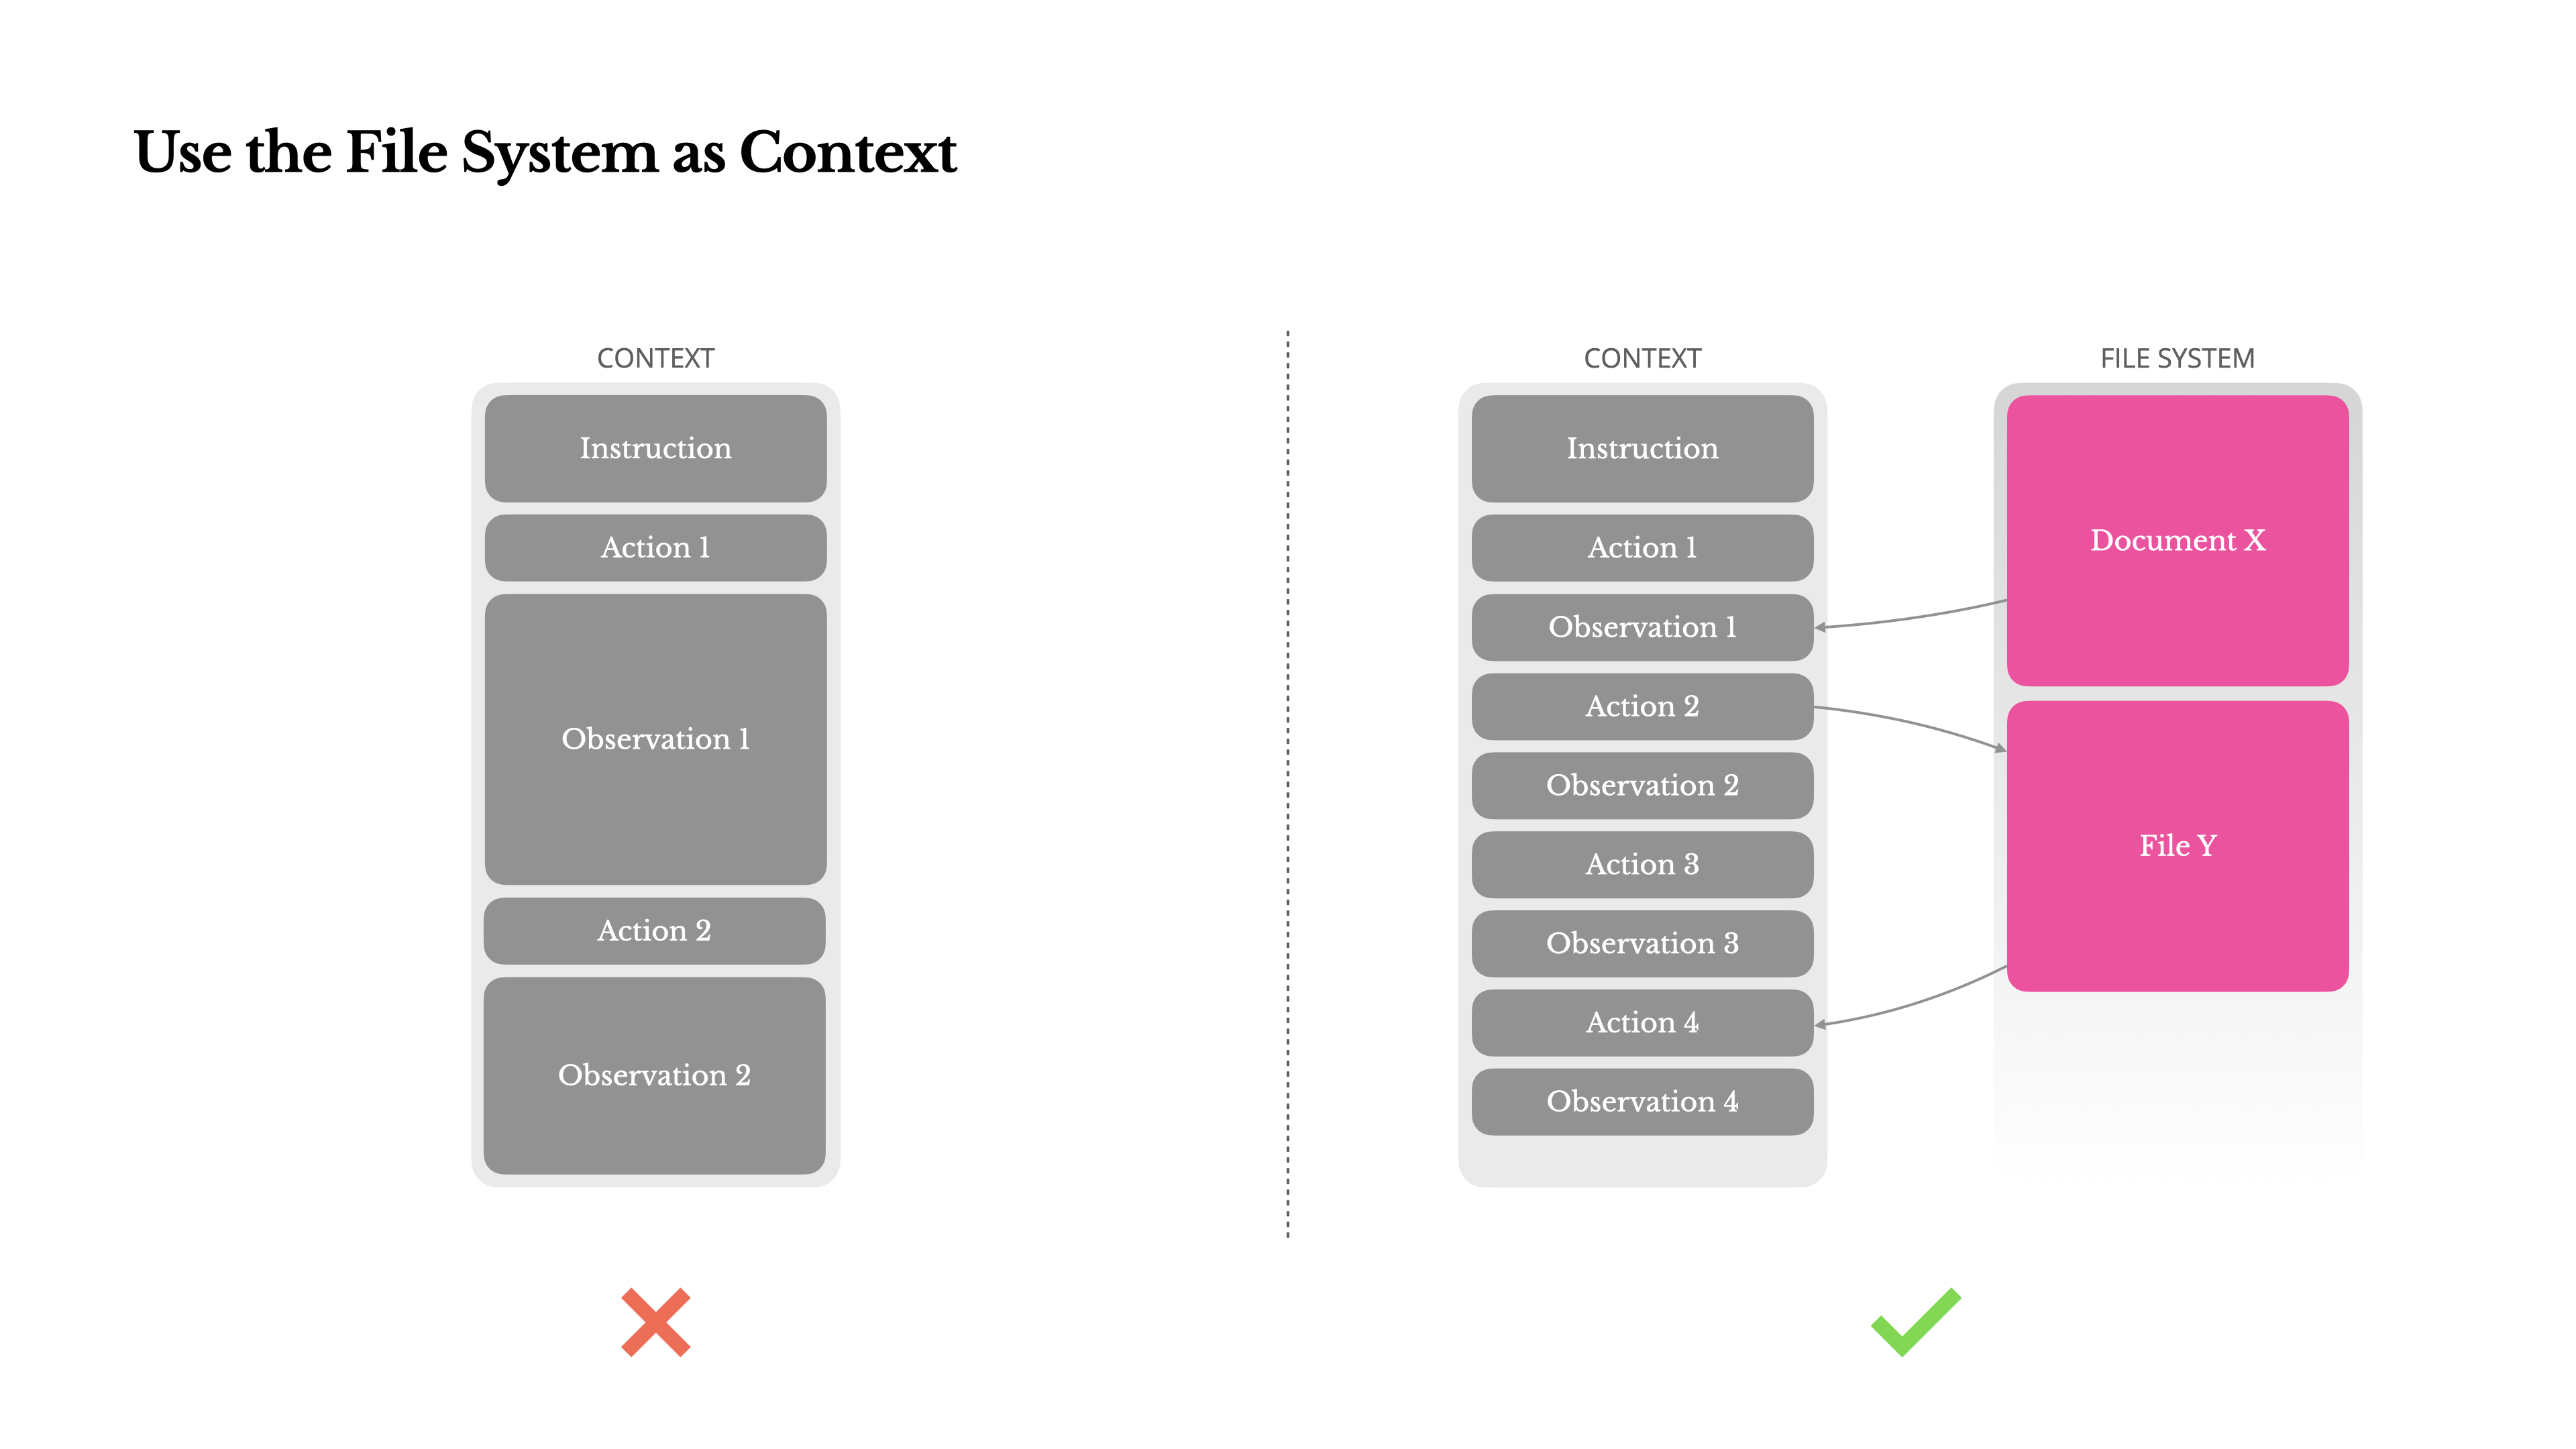
1.3.1. 文件系统作为持久化上下文
将文件系统视为终极上下文
- 大小不受限制
- 天然持久化
- 可直接操作
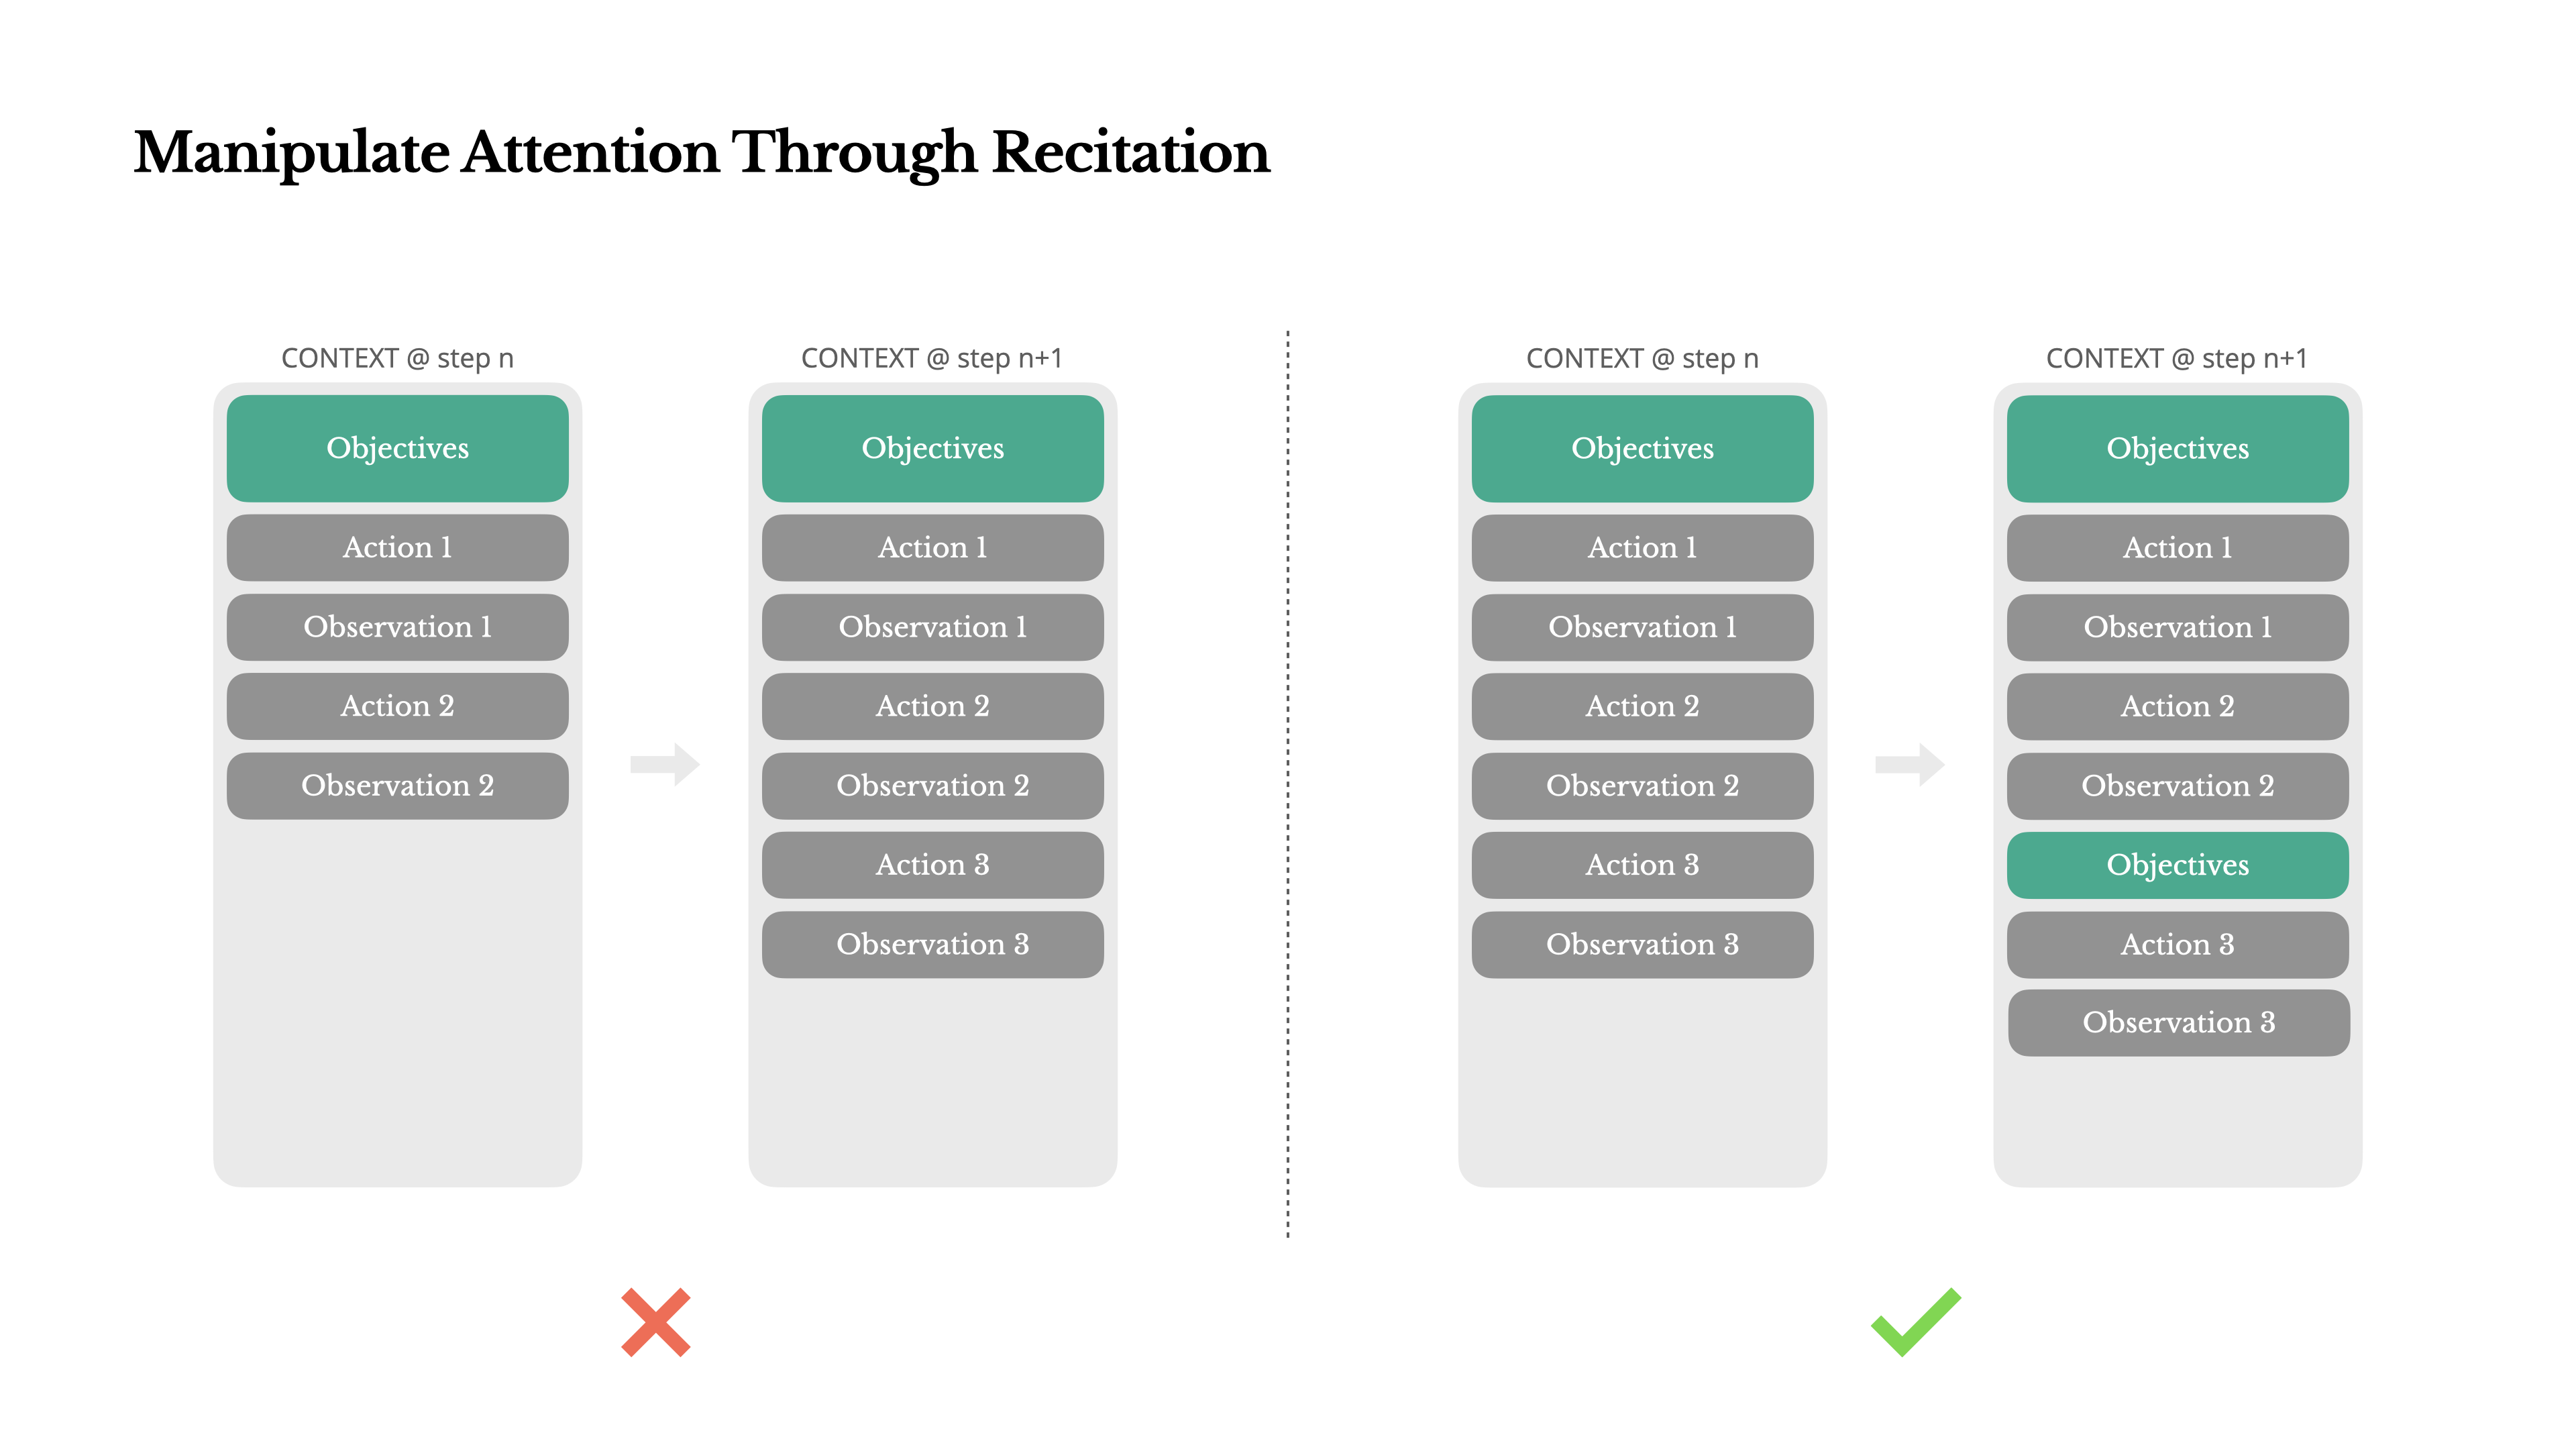
1.3.2. 注意力控制机制
# 典型的 todo.md 文件示例
- [x] 收集用户需求
- [ ] 分析技术方案
- [ ] 实现核心功能
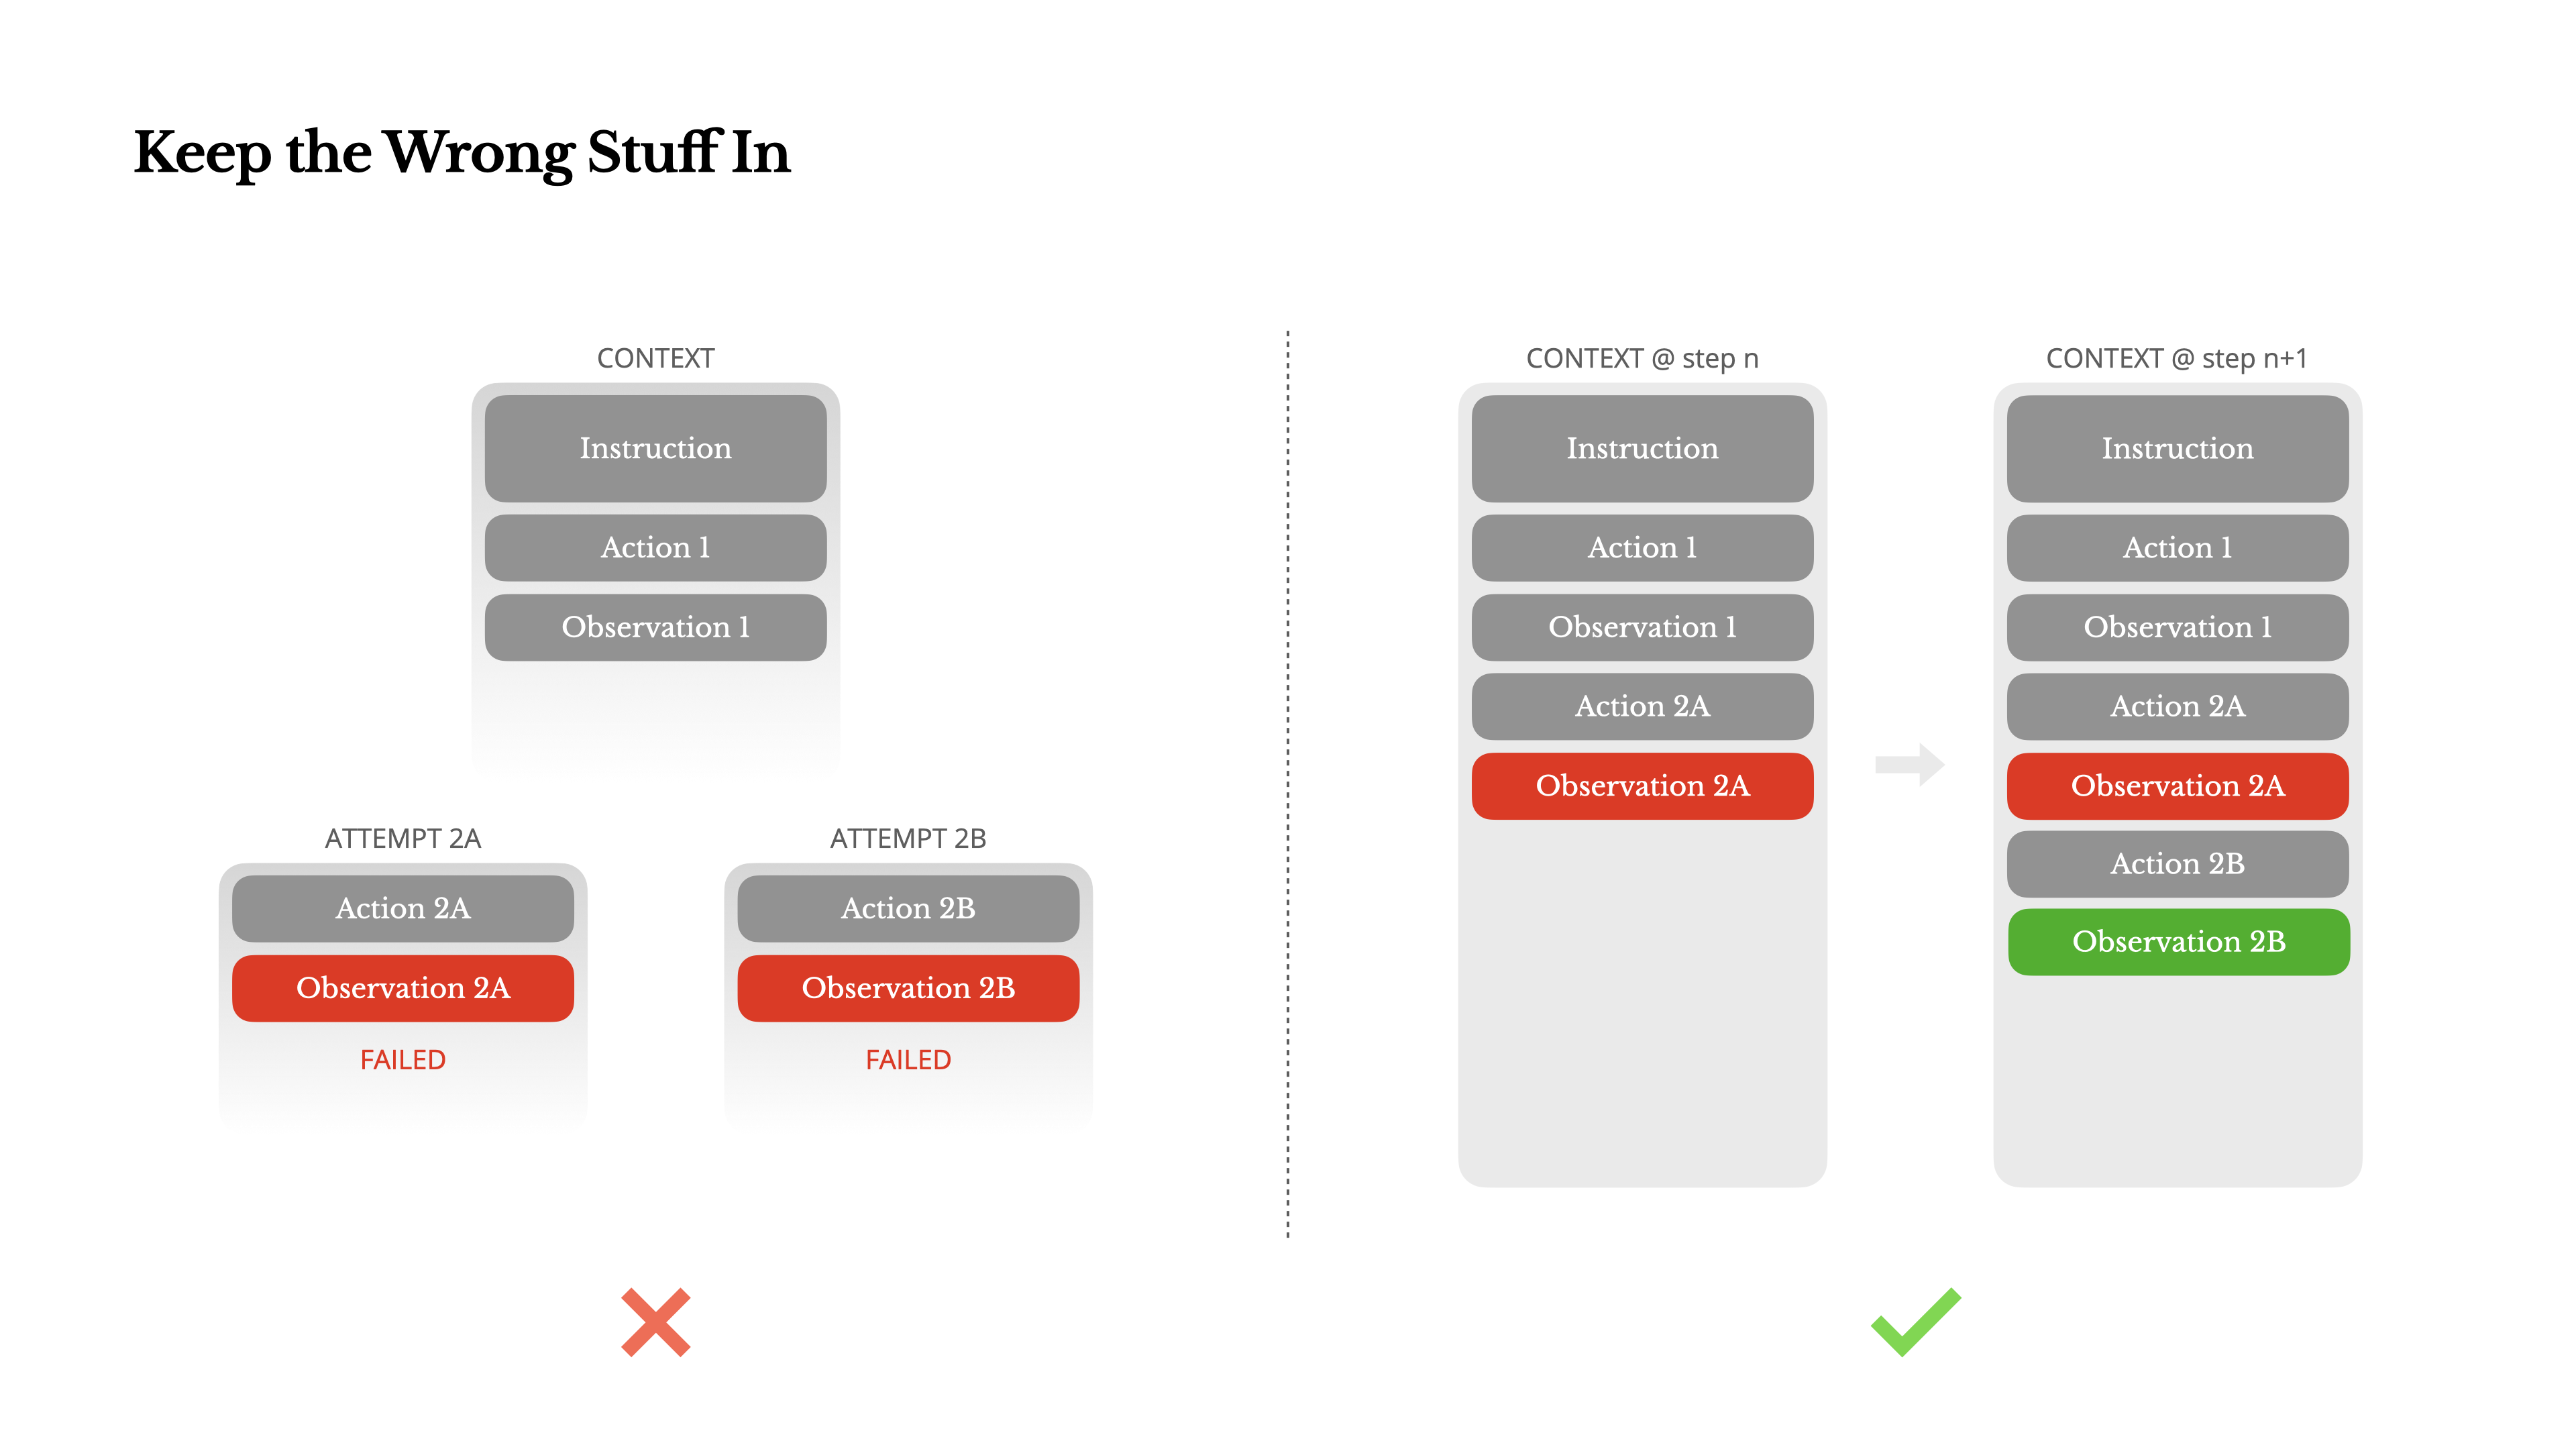
1.3.3. 错误处理与恢复
警告:擦除失败痕迹会移除改进证据!建议保留错误记录以帮助模型学习:
- 保留失败的工具调用记录
- 记录详细的错误观察结果
- 保留堆栈跟踪信息
1.4. 进阶优化技巧
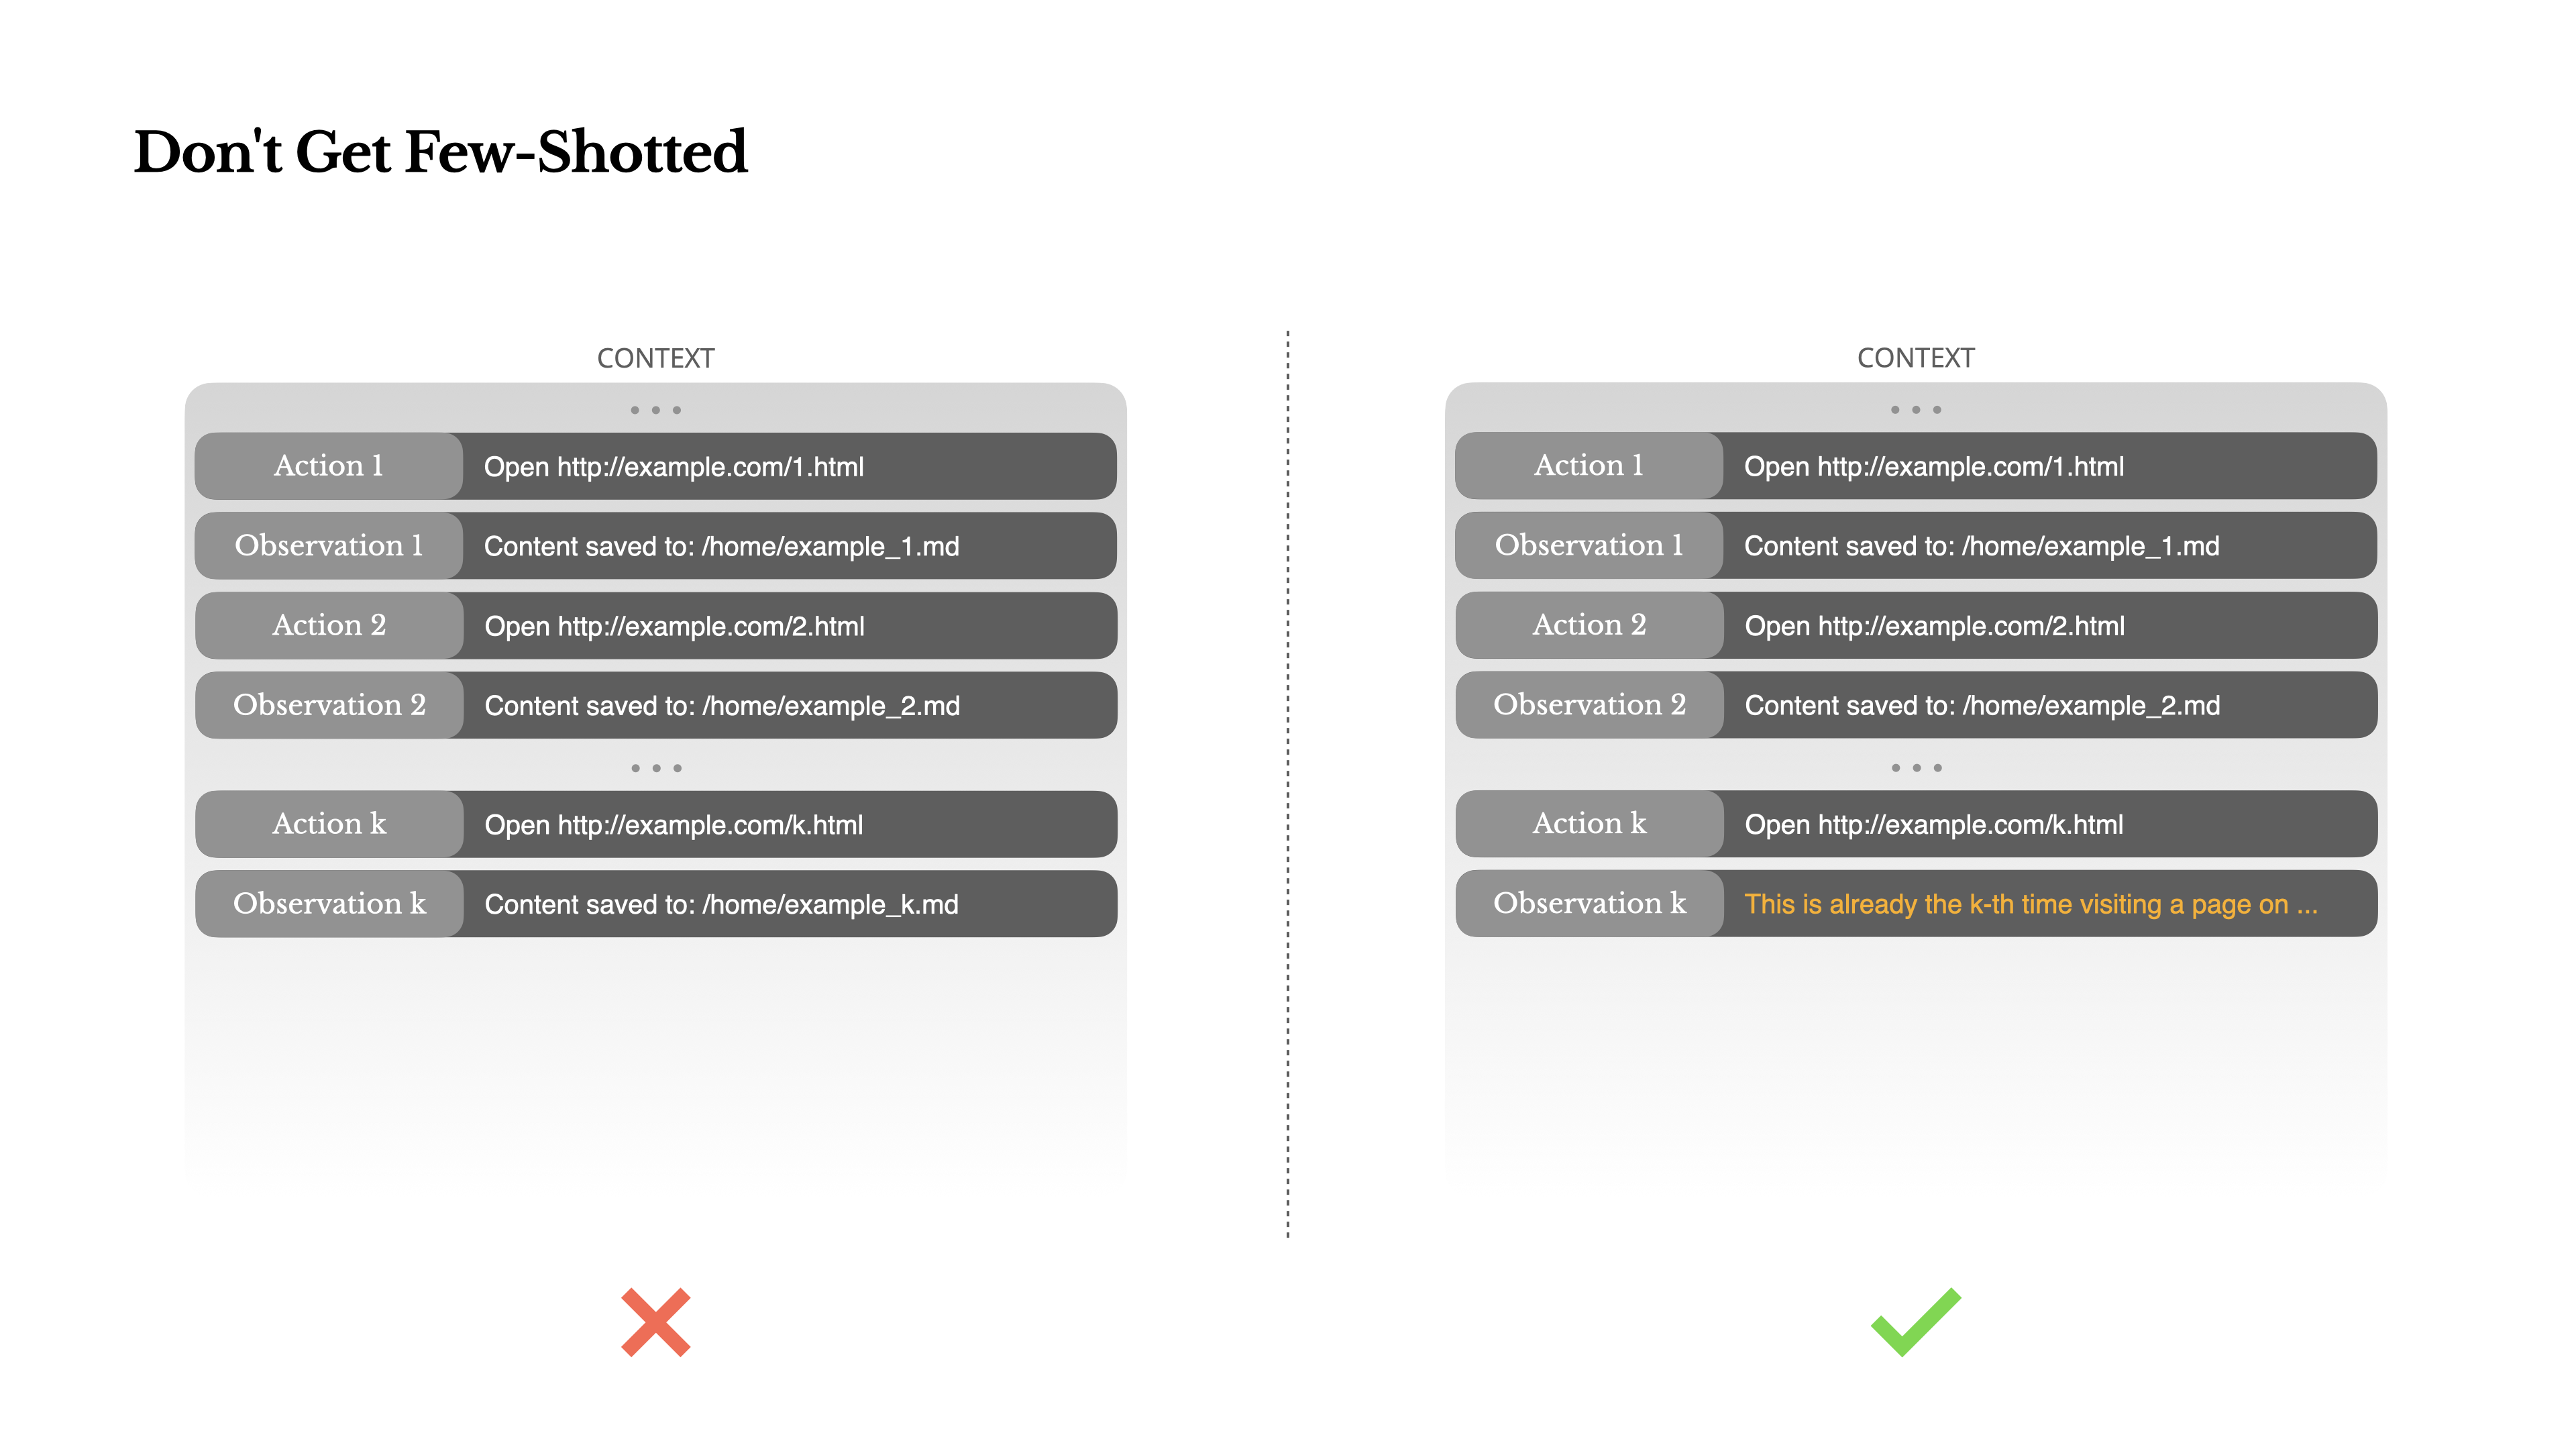
1.4.1. 避免少样本学习陷阱
说明:语言模型具有模仿倾向,建议采取以下措施:
- 引入结构化变化
- 使用多样化序列化模板
- 添加微小格式噪音
1.5. 结论
成功要点:上下文工程三要素
- 记忆管理
- 环境交互
- 反馈机制
智能体的未来将一次构建一个上下文。好好设计它们吧。